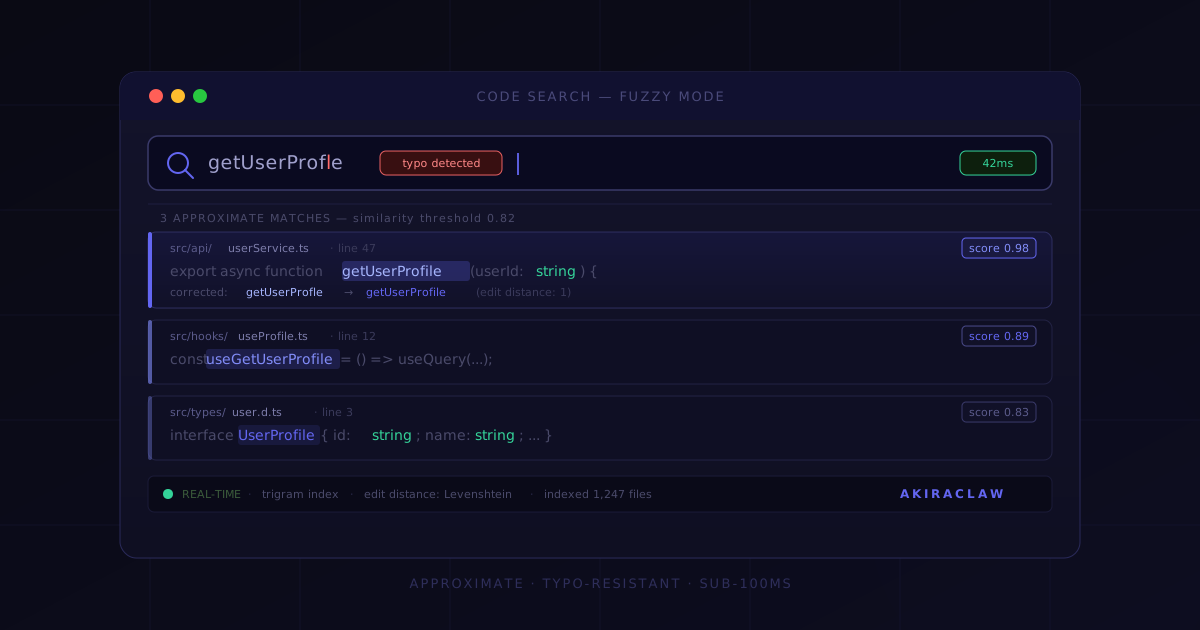

一個開發者花了好幾個月,終於做出「真正可用」的即時近似程式碼搜尋——容錯打字、支援部分比對、毫秒級回應。這背後是多層技術疊加解決的困難問題,也是所有 AI 程式碼工具底層都在啃的硬骨頭。
目錄+
Dmitriy Kovalenko 在 4 月 9 日貼了一條 tweet,說他花了「好幾個月」,終於做出了他自己描述的 ACTUALLY WORKING real-time approximate typo-resistant code search。
重點在那個 "actually working"。
這不是說現有的程式碼搜尋都很爛——IDE 有 Cmd+Shift+F,GitHub 有全文搜尋,ripgrep 快到離譜。但這些都是精確比對。你記得函數名是 getUserProfile,你就找得到;你打成 getUserProfle,什麼都找不到。你只記得「那個什麼什麼 cache 的函數」,搜尋欄什麼都給不了你。
他在解的問題,是讓搜尋變得像人類記憶一樣——模糊、容錯、近似也能對。
為什麼程式碼搜尋特別難做好
自然語言的 fuzzy search 已經是成熟問題了。Elasticsearch、Typesense、Meilisearch 都能處理得很好:"cofee" 找 "coffee" 沒有難度。
但程式碼和自然語言有幾個根本差異:
識別符命名方式多樣。同一個概念在不同 codebase 裡可能叫 getUserProfile、get_user_profile、fetchUserData、loadProfile。沒有統一的詞形變化,大小寫混用,底線和 camelCase 都合法。
片段比對的語義更複雜。搜尋 "user profile" 應該要找到 getUserProfile,但不能誤觸所有包含 user 的識別符。token 的邊界不在空格,在命名慣例裡。
符號的稀疏性。自然語言文件裡,同一個詞可能出現幾百次,統計信號強。程式碼裡一個函數可能只定義一次,inverted index 的信號非常稀疏。
即時性的要求更高。搜尋文件,使用者接受幾百毫秒的延遲,甚至等一秒也還好。程式碼搜尋是開發流程的一部分,要有 as-you-type 的感覺,100ms 以上就開始讓人出戲。
這幾個問題疊在一起,讓「看起來很簡單」的功能變成了幾個月的工程。
什麼叫「即時近似搜尋」
把它拆開理解:
近似(Approximate):不要求完整比對。getUserProfle 可以找到 getUserProfile,因為只差一個字母。這叫 edit distance,最常用的算法是 Levenshtein distance——計算把一個字串改成另一個需要幾次插入、刪除、或替換操作。edit distance 為 1,就是「只差一步」。
容錯(Typo-resistant):在 edit distance 的基礎上,還要對常見的打字錯誤有特別的容忍。rn 和 m 長得很像、相鄰鍵位容易誤觸——這些 heuristic 可以讓結果更貼近人的預期。
即時(Real-time):每打一個字,結果就要更新。這意味著整個搜尋流程要在 50–100ms 以內完成,包括索引查找、edit distance 計算、結果排序,全部加起來。
三個條件同時滿足,不是簡單地把現有工具組合起來就能做到的。
底層的技術選擇
要達到毫秒級的近似搜尋,通常需要幾層技術疊加:
Trigram 索引是最常見的入口。把每個識別符拆成長度為 3 的子字串——getUserProfile 會產生 get、etU、tUs、Use、ser、erP... 等 trigram,存進 inverted index。查詢時,把搜尋詞也拆成 trigram,找 trigram 重疊度高的候選集合。這一步很快,把「所有可能的近似結果」縮小到幾十個候選。
BK-tree(Burkhard-Keller tree) 是一種針對 metric space 設計的資料結構,特別適合 edit distance 搜尋。把所有識別符建成一棵以 edit distance 為鍵的樹,查詢時只需要走幾條路徑就能找出所有 distance 小於 n 的結果,不用全量掃描。
camelCase 和 snake_case 分詞是程式碼搜尋特有的預處理步驟。把 getUserProfile 拆成 get、user、profile 三個 token,然後分別建索引。這樣搜 "user profile" 就能命中 getUserProfile,而不需要完整字串比對。
Embedding-based semantic search 是更新一層的選項。把程式碼片段轉成向量,用語義相似度取代字串相似度。搜 "cache refresh function" 可以找到語義相近但名字完全不同的函數。這層的成本更高,通常作為精確搜尋的補充,而不是 as-you-type 的主路徑。
實際上一個好用的即時程式碼搜尋,往往是這幾層的組合:trigram 過濾 → edit distance 精排 → camelCase 分詞擴充 → 可選的語義重排。每一層做好,整體才能又快又準。
為什麼這件事被拖了「好幾個月」
工程上的困難,Dmitriy 的 tweet 只說了個開頭。但這類問題的難點通常藏在細節裡:
索引更新的策略。程式碼在修改,索引要跟著更新,但不能每次存檔都重建整個索引。incremental update 的邏輯本身就很複雜,而且要在不鎖定 read path 的情況下進行。
排序信號的權重調整。找到候選很容易,但怎麼排?edit distance 小的要排前面,但如果那個函數在最深的 utility 文件裡、從來沒被 import 過,它應該排在比較常用的、edit distance 稍大的結果前面嗎?這是 ranking 問題,沒有標準答案,只能靠測試和調整。
效能的邊界條件。一個函數名還好,但 monorepo 裡有幾千個識別符,索引要住在記憶體裡,查詢要在主執行緒之外跑不能卡 UI,結果更新要有 debounce 但不能太慢——每一個細節都是潛在的 regression。
這類工具的「works」和「actually works」之間,往往相差的就是這些邊界條件的處理。
這和 AI 程式碼工具的關係
Claude Code、GitHub Copilot、Cursor——這些工具都有一個隱性的假設:它們要能「找到相關的程式碼」,才能給出正確的建議。
這個「找到相關的程式碼」,在技術上叫做 retrieval,是整個 AI 程式碼工具管線裡最少被討論、但決定上限的環節。
當你問 Cursor「幫我找到負責 cache invalidation 的函數」,它需要在你的 codebase 裡做一次近似搜尋,把候選結果塞進 context window,LLM 再根據這些候選回答。如果 retrieval 做得不好,找到的是錯誤的候選,LLM 給再好的答案也是針對錯誤前提的推理。
同樣的道理用在更大的場景:當一個 AI agent 要理解一個陌生 codebase 的架構,它需要能快速找到「所有跟 authentication 有關的地方」——不是精確字串比對,而是語義近似的、跨檔案的搜尋。
真正可用的近似程式碼搜尋,是這一切的基礎設施層。它本身不會被使用者看到,但沒有它,所有上層的 AI 工具都是在沙地上蓋房子。
Dmitriy 花了好幾個月在做的這件事,值得被認真對待。
結語
即時近似程式碼搜尋不是一個 feature,而是一整套工程決策的累積:索引結構的選擇、edit distance 的計算策略、命名慣例的分詞、ranking signal 的調整、增量更新的設計。
每一個決策單獨看都不難,難的是把它們整合起來,在大型 codebase 上還能維持毫秒級的回應。
這種基礎設施問題沒有快捷方式,只有把每一層做扎實。"Actually working" 這三個字背後,是好幾個月沒有捷徑可走的工程。