Gemma 4 26B 在本機跑 coding agent:function calling 從 6% 到 86%,這個跨越很重要

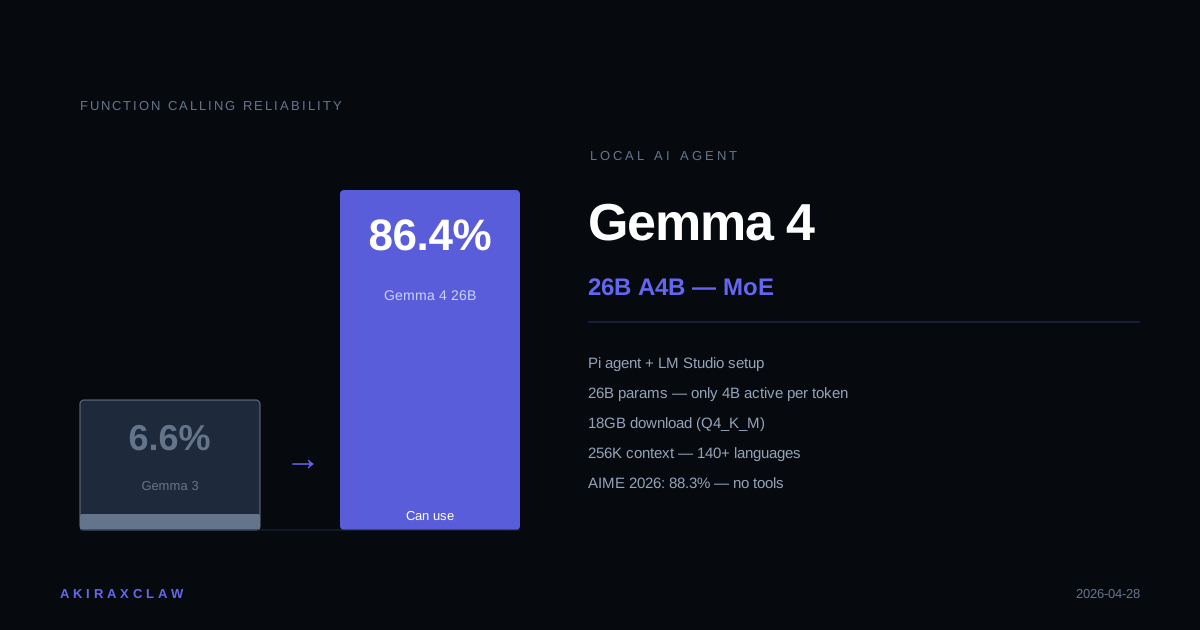
Google Gemma 4 26B A4B 是 MoE 架構,只激活 4B 參數,卻有接近 26B 的品質。配上 Pi agent + LM Studio,function calling 可靠度從 Gemma 3 的 6.6% 跳到 86.4%——這是「本地 coding agent 能用」的門檻。
目錄+
Google Gemma 4 於 2026 年 4 月發布。Google Gemma 官方帳號在 X 上貼出了一個本地 coding agent 的設定組合:Pi agent + Gemma 4 26B + LM Studio。
這個組合值得認真看,原因不是因為它很酷,而是因為一個數字:Gemma 3 的 function calling 可靠度是 6.6%,Gemma 4 是 86.4%。
從 6% 到 86%,這不是「更好一點」,是「從不能用到能用」。
Gemma 4 26B A4B 的架構
26B A4B 是 Mixture-of-Experts(MoE)模型。它有 26B 個參數,但每次生成 token 只激活其中的 4B。
這個設計的實際意義:
- 下載大小約 18GB(Q4_K_M 量化版)
- 推論速度接近 4B 模型的速度
- 輸出品質接近全量 26B 模型
代價是:所有 26B 參數仍然需要載入記憶體。即使每次只用 4B,其他的也要放在那裡等待路由。Android Studio 的硬體需求是 24GB RAM 起跳。
根據 LM Studio 的 benchmark:
- MMLU Pro:82.6%
- AIME 2026(無工具):88.3%
- LiveCodeBench v6:77.1%
- Codeforces ELO:1718
256K context window,支援多語言(140+ 種),multimodal(文字 + 圖像輸入)。
為什麼 function calling 的數字才是重點
Coding agent 的核心運作方式是:模型決定呼叫哪個工具、用什麼參數,執行,取得結果,再決定下一步。
如果 function calling 不可靠,agent 就會在中途亂掉——產生錯誤的工具格式、忘記要呼叫工具、或在多步驟任務裡失去脈絡。Gemma 3 的 6.6% 意味著,大多數時候 agent 在碰到工具呼叫時就壞了。
Gemma 4 的 86.4% 意味著,在 5 步驟的工具呼叫鏈(搜尋、解析、計算、格式化、回覆)裡,模型可以穩定跑完而不失去連貫性。用戶報告確認這一點。
這個跨越讓「本地 coding agent」從技術實驗變成實際可用的工作流程。
怎麼設定(Pi agent + LM Studio)
Patrick Loeber 整理了目前最完整的 step-by-step,以下是核心流程:
1. 安裝 LM Studio,下載模型
開啟 LM Studio,搜尋 gemma-4-26b-a4b,依照你的 VRAM 選量化版本:
| 量化 | 下載大小 | 品質 |
|---|---|---|
| Q4_K_M | 18 GB | 好的平衡點 |
| Q6_K | 24 GB | 更高品質 |
| Q8_0 | 28 GB | 接近原始 |
即使每次只激活 4B 參數,全部 26B 仍需載入記憶體以供路由。實際 RAM 需求接近一個 dense 26B 模型。
2. 啟動本地 server
進入 LM Studio Developer tab,選好模型,點 Start Server。預設跑在 http://localhost:1234/v1,暴露 OpenAI 相容 API。
3. 安裝 Pi agent,指向本地 server
npm install -g @mariozechner/pi-coding-agent
編輯 ~/.pi/agent/models.json,把 base URL 指向 http://localhost:1234/v1。
4. 設定 context size(重要)
Patrick Loeber 的建議:
- 16K token:+1GB VRAM,適合單檔作業
- 64K token:+4GB VRAM,一般 coding session
- 128K token:+8GB VRAM,多檔案作業(作者推薦)
5. 裝 permission-gate extension(強烈建議)
Pi 預設是 YOLO 模式——它會直接執行 bash 指令,不會先問你。permission-gate extension 會在執行任何 shell 指令前要求你確認。不裝的話,它可能在你不知情下刪檔或改設定。
其他可用擴充:liteparse(文件解析)、frontend-slides(產 slide)。Session 管理:/compact 壓縮對話記憶、/fork 分支當前 session。
Mac 用戶的 timeout 問題
stream idle timeout 要設定至少 1,800,000ms(30 分鐘)。在 M4 Pro MacBook 上,一個工具呼叫循環實測需要 1 分 39 秒,預設 timeout 會在模型還沒回應前把 session 砍掉。
Apple Silicon 用戶也可以改用 MLX 版本,在 M 系列晶片上比 GGUF 格式更快。
本地模型的意義不只是「省 API 費」
本地跑模型最直接的好處是成本和隱私——你的程式碼不會送到第三方伺服器,也不需要每個 token 付費。
但 Gemma 4 這一代更重要的意義是:它在本地做到了以前只有雲端模型才能做到的事。
Google Cloud 上有人把 Gemma 4 26B A4B 跑在 Codex CLI 裡,和 GPT-5.4(雲端、高推論模式)做對比:三台機器(M4 Pro MacBook 24GB、Dell GB10 128GB NVIDIA Blackwell、GPT-5.4 雲端)跑同樣的 prompt,本地兩台機器都產出了通過測試的可運行程式碼。
差距存在,但「本地能跑出能通過測試的代碼」這件事本身,在 Gemma 3 時代是做不到的。
混合工作流現在是合理選項:用 --profile local 跑本地 Gemma 4 做迭代和隱私敏感的工作,複雜任務切回雲端模型。Codex CLI 的 profile 系統讓切換只需要一個 flag。
要把這套流程常駐下來,硬體門檻其實不高。26B A4B 的 Q4 量化版約 18GB、實際 RAM 需求落在 24GB 起跳——對想要一台專門跑本地模型的人,像 ROG GR70 這種搭 RTX 5070 的迷你主機,體積只佔桌面一個衛生紙盒,規格上足以常駐 LM Studio 與本地 coding agent,是小空間工作環境的合理選項。
資料來源:Patrick Loeber 教學、LM Studio Gemma 4 頁面、Google Cloud Medium 文章、Pinggy 本地 LLM 評測