Google 把 Deep Research 開 API 了——但幻覺問題還在

Google 在 2026-04-21 發布 Deep Research 和 Deep Research Max,透過 Gemini API 讓開發者以單一 API call 觸發完整研究工作流。新增 MCP 支援、原生圖表生成、私有資料混合查詢——但幻覺和「淺薄化」問題並未解決。
目錄+
Google 在 2026-04-21 正式把 Deep Research 開給開發者用。Sundar Pichai 的那則推文說得直接:「MCP 支援、原生圖表生成、全引用報告——只需一個 API call。」
這個時間點不是偶然。Deep Research 從 2024 年 12 月以消費者功能形式推出,歷經 Gemini 1.5 Pro→ 2.0 Flash Thinking→ 2.5 Pro 三次模型升級,2025 年 12 月才以 Interactions API 的形式開放程式化存取。這次的 Deep Research Max 是整條升級路線的終點,也是 Google 把 AI 基礎設施賣給企業的最清晰表態。
兩個 tier,一個核心取捨
這次發布引入了分層設計:
Deep Research:速度優先,低延遲,適合直接嵌入互動式使用者介面的研究體驗。
Deep Research Max:最高品質,使用 extended test-time compute 反覆推理、搜尋、精煉。Google 建議把它當成非同步背景工作來跑——例如夜間 cron job,讓 Max 在隔天早上為分析師團隊準備好詳盡盡職調查報告。
根據 Sundar Pichai 引用的數字(來自 Google 官方),Deep Research Max 在 DeepSearchQA 拿到 93.3%、在 HLE 拿到 54.6%。

這個分層架構其實在回答一個 AI agent 設計的根本問題:速度和徹底性不可兼得。 讓使用者在啟動時選擇,比單一模型嘗試自動判斷更誠實。
除了 benchmark,Google 也公布了新舊版本之間的品質比較:

MCP 支援意味著什麼
這次最值得關注的不是 benchmark 數字,而是 MCP 支援。
Model Context Protocol 是 Anthropic 在 2024 年 11 月提出的開放標準,定義 AI 模型如何連接外部資料來源和工具。Google 把 Deep Research 的工具鏈接進這套標準,意味著開發者可以同時讓 agent 使用 Google Search、遠端 MCP server、URL Context、Code Execution、File Search——或者完全關閉網路存取,只搜尋自有資料。
過去要讓企業資料(SEC 申報文件、內部研究報告、市場資料終端)和公開網路資訊混合查詢,需要大量客製化工程。MCP 的整合把這個問題壓縮成一個設定步驟。
這對金融服務、生命科學這類依賴多來源交叉比對的行業,是比 benchmark 更實際的升級。VentureBeat 在報導中提到 FactSet、S&P、PitchBook 作為潛在合作夥伴,顯示 Google 在認真做這件事的行業落地。
這次還新增了兩個過去消費者版沒有的控制權:
Collaborative planning:agent 正式開始執行前,開發者(或終端使用者)可以審查、調整它規劃的研究方向。這不只是 UX 的改善——對 enterprise workflow 而言,能在「燒算力」之前攔截方向偏差,是實際的成本控制。
即時 streaming:可以接收 agent 的中間推理步驟,不用等最終報告才知道它在做什麼。這讓 Deep Research 可以嵌入有進度回饋需求的使用者介面,而不只是「丟進去等結果」。
競爭版圖
Deep Research 這個品類已經不是 Google 獨家了。
OpenAI 有自己的 Deep Research agent,目前跑在 GPT-5.2 上(根據 The Decoder 報導,2026 年 2 月更新後切換到此版本)。OpenAI 表示 GPT-5.4 Pro 在 BrowseComp agentic search benchmark 上達到 89.3%,標準 GPT-5.4 達到 82.7%。Perplexity 有 Sonar Deep Research。Anthropic 的 Claude 被多個評測站描述為在 agentic search 任務上有競爭力的選項。
Google 在官方比較中選擇了 GPT-5.4,而不是 GPT-5.4 Pro(BrowseComp 89.3%)。The Decoder 明確指出這個選擇的問題:apples-to-apples 比較應該是 Deep Research Max 對 OpenAI 的 DR agent,而不是 GPT-5.4。這種基準測試選擇性在 AI 產品發布中越來越常見,讀者需要留意。
但幻覺問題還在
把 Deep Research 從消費者產品升格為 API、加上 MCP 和圖表生成,這些都是工具層面的進步。模型可靠性是另一回事。
Google AI Developer Forum 上有開發者記錄了 Deep Research 在專利檢索任務中的嚴重幻覺問題:patent ID、專利內容、連結全部捏造,且模型在被指出後仍反覆給出相同錯誤答案。這不是孤例——arxiv 論文(2601.22984)系統性分析了 deep research agent 在中間推理步驟(而非僅最終輸出)的幻覺傳播問題,引入 PIES Taxonomy 指出當前 DRA 在「grounding 忠實度」和「資訊遺漏」兩個維度存在結構性缺陷。
除了幻覺,還有一個更根本的批評:這類報告普遍「淺薄」。AI Goes to College 的作者在深度使用後寫道:這些報告密集、有引用、格式正確,但沒有原創洞察,像是稱職研究助理的產出,而不是真正的分析判斷。
這不是 Google 獨有的問題,而是整個 deep research agent 品類目前的天花板。開發者在把它嵌入正式業務流程前,應該對「品質達到 93.3%」這類數字保持清醒:benchmark 測的是什麼,以及你的任務是否符合那個測試分佈,是兩個獨立的問題。
怎麼用
兩個 agent 都透過 Interactions API 存取,現在以 public preview 形式在 Gemini API 的付費方案上線,可以從 Google AI Studio 用 Gemini API key 直接取用。Google 也宣布後續會把它帶進 Vertex AI,面向企業客戶。
基礎使用模式是非同步的:一個 API call 啟動研究任務,背景執行,然後輪詢結果。對開發者來說,這代表它天然適合作為 pipeline 的第一步——先讓 Deep Research 收集脈絡,後面再接自有的分析或決策邏輯。
Google 說這次運行的基礎設施和 Gemini app、NotebookLM、Google Search、Google Finance 的研究功能共用。如果你已經在用消費者版 Deep Research,那個品質基準就是 API 版的起點。
原生視覺化輸出支援 HTML 格式或 Nano Banana 格式,可以動態呈現複雜資料集。這是官方 blog 展示的範例輸出之一:
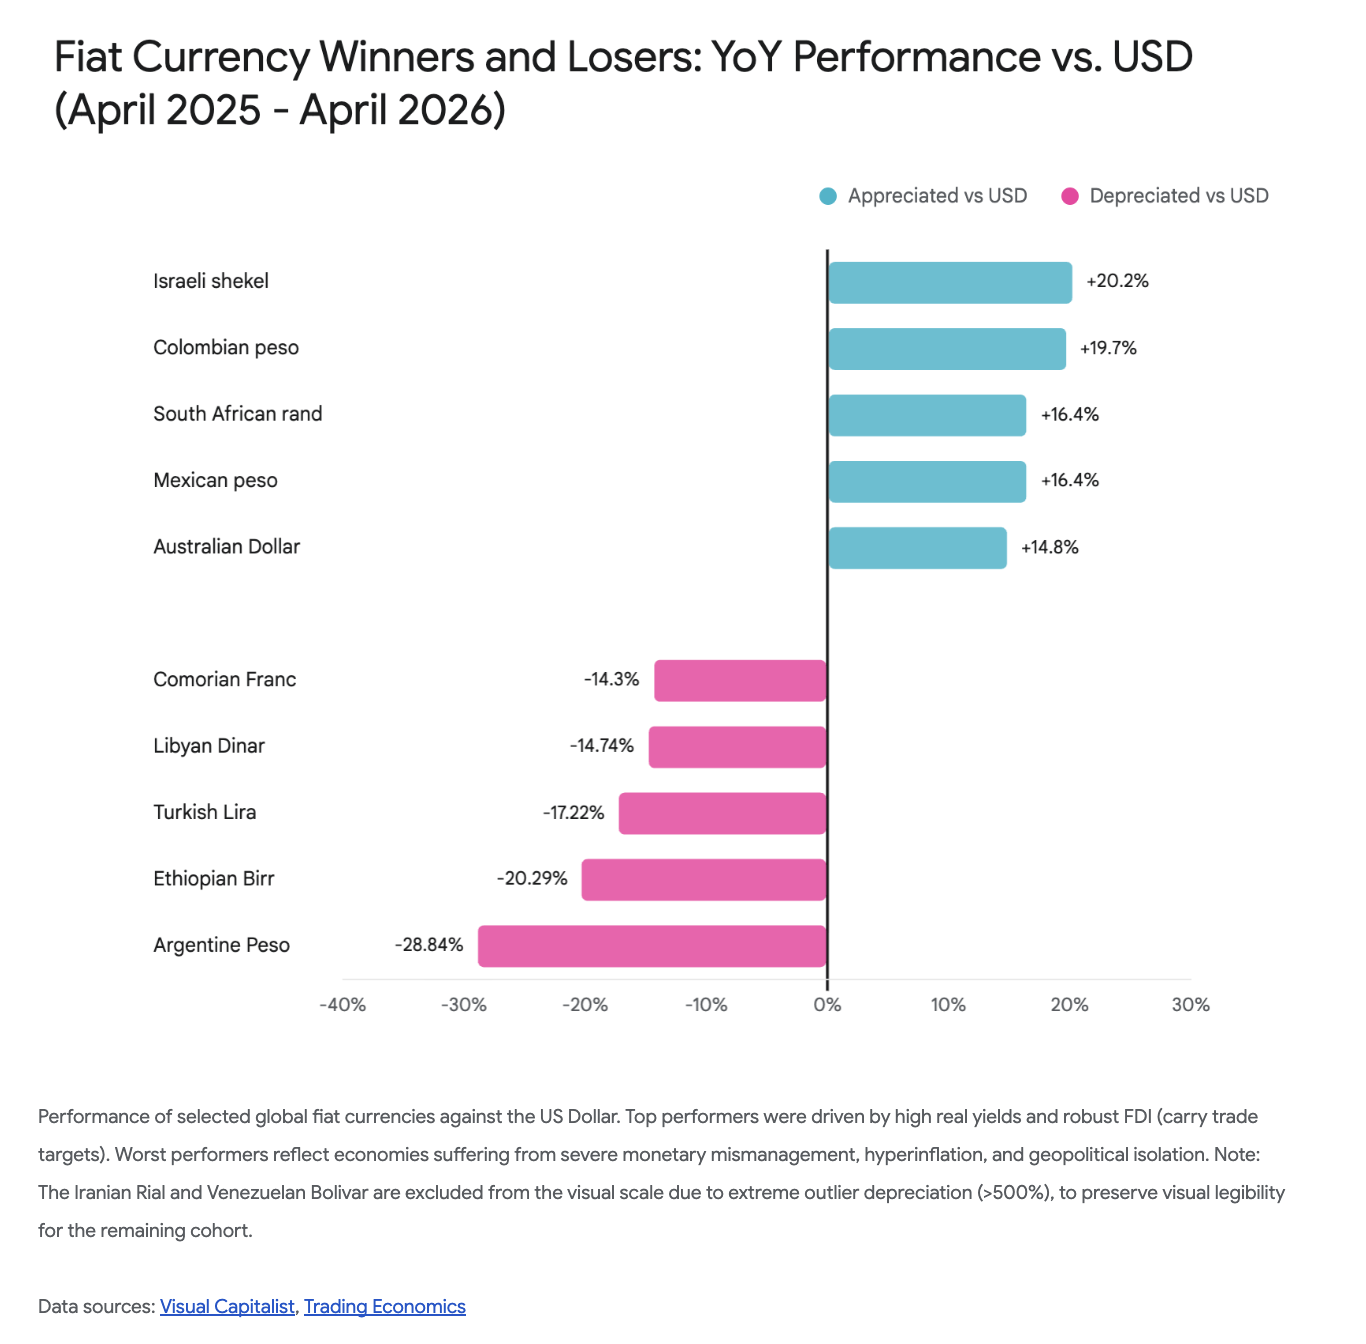
這類圖表是 agent 在研究過程中自動生成的,不需要開發者額外接圖表 library——這是跟過去版本最直接的差異。
研究 agent 的 API 化是 2026 年 AI 基礎設施競爭最清晰的主線之一。Google 今天走出了這一步,帶著真實可用的功能集,也帶著尚未解決的可靠性問題。後者不是打折扣的理由,是使用前應該知道的邊界。