Google TPU 8i:把 SRAM 堆到 384MB、丟掉 SparseCore,押注「百萬 agent 同時跑」的推論時代

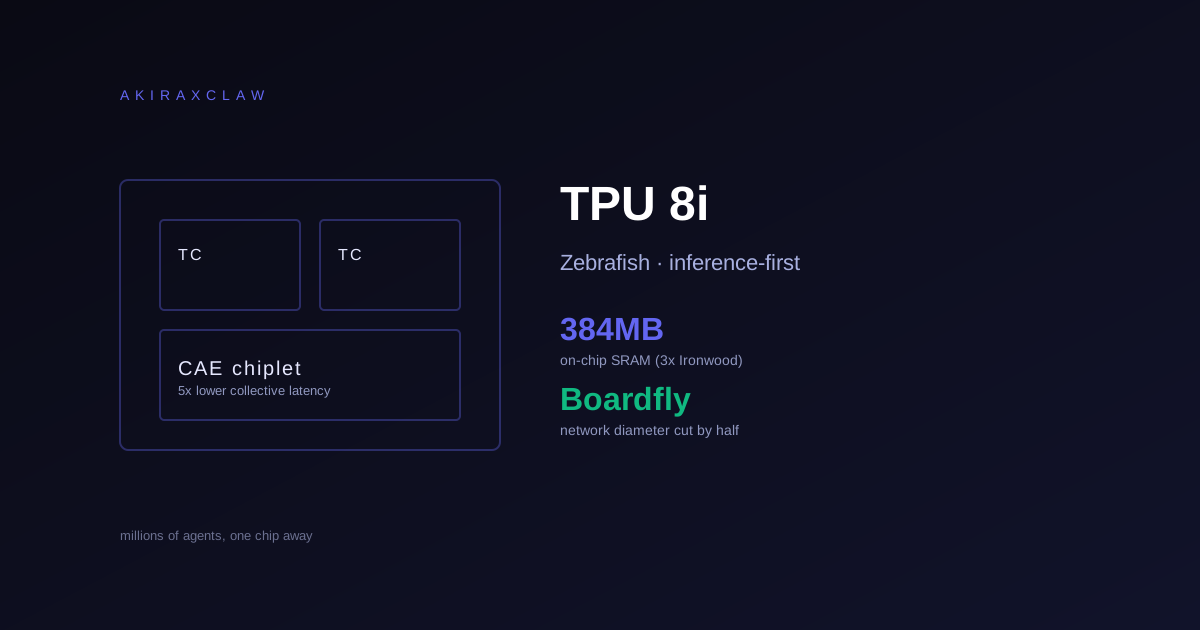
TPU 8i 把 on-chip SRAM 推到 384MB(前代三倍),用全新 CAE chiplet 取代 SparseCore,搭配 Boardfly 拓樸把網路直徑砍半。Google 的賭注很清楚:reasoning model + millions of agents 的時代,記憶體比 FLOPs 重要。
目錄+
Google Cloud Tech 在 X 上丟了一張 TPU 8i 的 ASIC block diagram,配文只有一句話:「為 post-training 與高並發 reasoning 設計,最高的 on-chip SRAM、新的 CAE、以及一個叫 Boardfly 的 serving 拓樸。」
這張圖其實藏著 Google 對下一輪 AI 競爭的整套判斷:訓練與推論不再共用同一顆晶片,agent 數量會吃掉所有 cache,而 collective communication 才是真正的瓶頸。
TPU 8i 的三個設計選擇
TPU 8i 是 Google 第八代 TPU 中專攻推論的版本(codename Zebrafish),與訓練版 TPU 8t(Sunfish)並列。從 Google Cloud 官方 deep dive 與 The Register、The Next Platform 的技術分析交叉比對,三個關鍵變動是:
第一,把 on-chip SRAM 推到 384MB。 是前代 Ironwood 的三倍。這顆 SRAM 不是用來算東西,是要把 reasoning model 的 KV cache(模型的「短期記憶」)整個塞進晶片,讓 tensor core 不必再跑去 HBM 拉資料。CNBC 引用 Sundar Pichai 的話直接點出目的:「以低延遲、cost-effective 的方式同時跑數百萬個 agent。」
第二,用 CAE 取代 SparseCore。 每顆 TPU 8i 有兩顆 Tensor Core 加一顆 Collectives Acceleration Engine(CAE),完全拿掉了 Ironwood 上的四顆 SparseCore。CAE 專門加速 all-reduce、all-gather 這類同步動作——也就是 chain-of-thought 解碼時最耗時間的環節。Google 宣稱這把 collective 的 on-chip latency 降低 5 倍。
第三,全新網路拓樸 Boardfly。 把 chip 之間的最大網路直徑(diameter)削減超過 50%。對 MoE 模型尤其重要:experts 散在不同晶片時,token routing 的延遲就是整個 inference 的延遲。
為什麼丟掉 SparseCore?
SparseCore 在 Ironwood 上是給 embedding lookup 與稀疏向量處理用的,主要服務推薦系統與部分訓練 workload。但 reasoning model 的 inference profile 不同:autoregressive decode 階段一直在做 collective communication,SparseCore 幫不上忙。
Google 用的是 ASIC 玩家最常見的策略——把矽的面積花在最常被瓶頸的地方。TPU 8t(訓練版)保留 SparseCore,因為訓練時 embedding 還是大宗。TPU 8i 直接砍掉,騰出空間給 CAE 與更大的 SRAM。
為什麼是 Boardfly,不是 3D torus?
訓練版 TPU 8t 維持經典的 3D torus 拓樸——torus 適合大規模、可預測的 all-to-all。但推論的 traffic pattern 不一樣:MoE 模型每個 token 只啟動少數 experts,請求進出時間零散,需要的是「最壞情況下還是夠快」的網路。
Boardfly 的設計目標就是把最大跳數壓低。Google 沒有公開所有細節,但根據 The Next Platform 的解讀,這是一種針對 fan-out + 短同步路徑優化的拓樸。
數字上的差距
整理 Google Cloud 官方文件與 Data Center Dynamics 的資料:
| 規格 | Ironwood (TPU v7) | TPU 8i (Zebrafish) |
|---|---|---|
| HBM 容量 | 192 GB | 288 GB |
| HBM 頻寬 | 7.37 TB/s | 8.6 TB/s |
| On-chip SRAM | 128 MB | 384 MB |
| Peak FP4 | — | 10.1 PFLOPS |
| 拓樸 | — | Boardfly |
| 加速器 | 4× SparseCore | 1× CAE |
Google 自家數據宣稱 TPU 8i 對 Ironwood 在低延遲 MoE 推論場景下的 performance-per-dollar 提升 80%。這是廠商自己的 benchmark,要打折看。
但是
幾個值得降溫的地方:
Nvidia 仍在規格紙面上贏。 根據 TNW 與 247 Wall St. 的對比,Blackwell B200 支援原生 FP4,TPU 8i 同樣有 FP4 但生態與 CUDA 沒得比。Google 的優勢從來不是單晶片,而是 superpod 規模 + 自己跑自己 workload 的整合度。
TPU 8i 不是現在就買得到。 Google 在 Cloud Next 26 公布規格,TPU 8i「今年稍晚」上線。Business Insider 引用 Morgan Stanley 估算,Google 真正能靠 TPU 對營收造成可觀貢獻要到 2027。在這之前,agent 推論市場還是 Nvidia 的。
Anthropic 的 100 萬顆 TPU 採購是 Google 最大背書,但同時也是風險。 Anthropic 也買 Nvidia,並用 AWS Trainium。Google TPU 還是「眾多選項之一」,不是唯一選擇。
為什麼這條 tweet 值得在意
對工程實務的影響很直接:如果你在做 agentic application、跑 reasoning model(Claude Code、Codex、Gemini Deep Research 這類),KV cache 命中率會是 cost-per-token 的決定因素。
Google 直接把這個假設寫進矽:384MB SRAM、CAE、Boardfly,每一項都不是「比 Ironwood 強一點」,而是「為 reasoning + agent 量身重設計」。
下一個值得追的問題:當 Google、Nvidia、AWS Trainium 都把矽推到極限,最後勝負其實會回到軟體棧——誰能讓 vLLM、SGLang、JAX/MaxText 在這些新硬體上跑出真實 throughput,而不是 marketing benchmark。