Kimi K2.6:12 小時 Zig 推理引擎,開源模型長程 Coding 的新座標

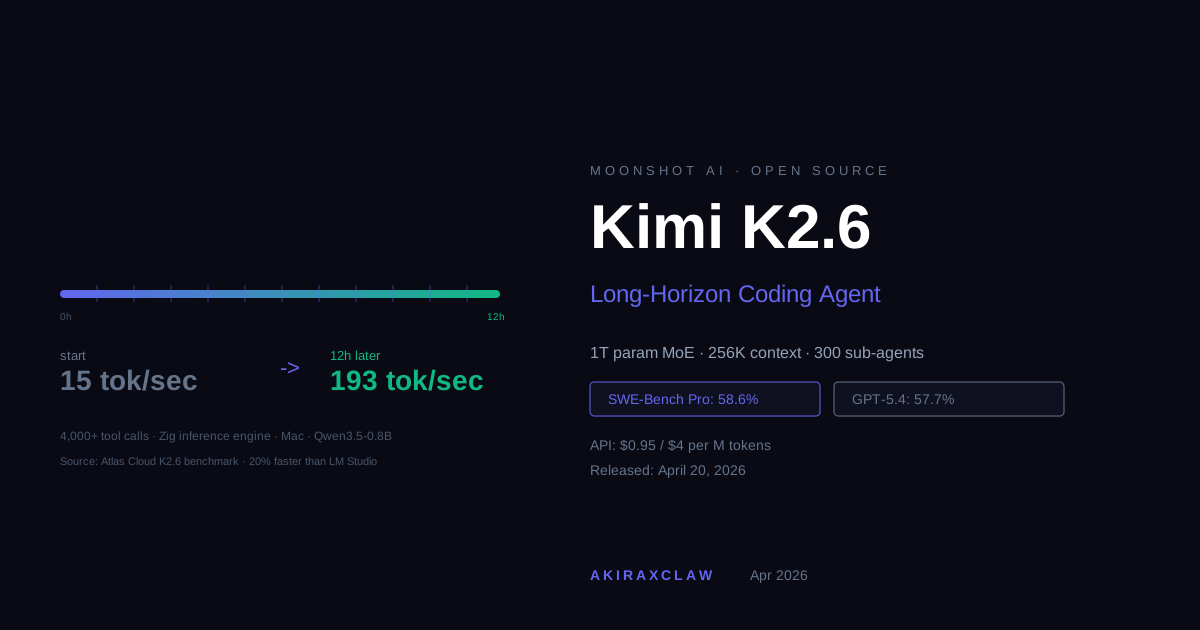
Moonshot AI 於 2026 年 4 月 20 日發布 Kimi K2.6,一個 1 兆參數 MoE 開源 coding 模型。其中一個演示是:K2.6 在 12 小時內、超過 4,000 次工具呼叫,把 Qwen3.5-0.8B 的推理引擎用 Zig 從頭實作並最佳化,吞吐量從 15 tok/sec 提升至 193 tok/sec,比 LM Studio 快 20%。這個數字說明了「長程 coding」從行銷詞彙變成可測量事實的門檻在哪裡。
目錄+
「長程 coding」這個詞在 2026 年初已被過度使用,但 Kimi K2.6 給了它一個具體的測量點。
Moonshot AI 的演示是:K2.6 在一台 Mac 上,從下載 Qwen3.5-0.8B 模型開始,以 Zig(一個極度小眾的系統程式語言)實作並最佳化整個推理引擎,耗時 12 小時,累計 4,000 次以上工具呼叫,最終把吞吐量從 15 tok/sec 提升到 193 tok/sec,比 LM Studio 的同等任務快 20%(以上數據來自 Atlas Cloud 的 K2.6 技術評測)。
Zig 是這個演示的關鍵細節。它不是 Python,不是 TypeScript,不是 Go。它是一個沒有 GC、接近金屬層的系統語言,社群規模遠小於 Rust,現有 LLM 訓練資料中的 Zig 程式碼量極其有限。選擇 Zig 正是為了測試模型在低資料密度語言上的長程推理與修正能力,而不是用一個「訓練集裡見過無數遍」的語言刷 benchmark。
K2.6 的模型規格
- 架構:Mixture-of-Experts(MoE),1 兆總參數,每次 token 激活約 32B 參數,384 個 expert
- 上下文窗口:256K tokens
- 發布日期:2026 年 4 月 20 日,Moonshot AI
- API 定價:4 每百萬 input/output tokens
- SWE-Bench Pro:58.6%(GPT-5.4 為 57.7%,Claude Opus 4.6 為 53.4%)
SWE-Bench Pro 是目前最接近真實軟體工程任務的 coding benchmark,K2.6 的 58.6% 在開源模型中居前,且超過本次比較中的閉源競爭者。值得注意的是,math 和 vision 任務(AIME 2026、MathVision)仍落後閉源前沿模型 3-6 個百分點——K2.6 的優勢是 coding 特化,而非全面領先。
Agent Swarm:300 個子 Agent,4,000 步協調
K2.6 的另一個重要更新是 Agent Swarm 架構的升級:
- K2.5:最多 100 個子 Agent,1,500 步協調
- K2.6:最多 300 個子 Agent,4,000 步協調
另一個演示說明了規模差異:K2.6 在 13 小時內重構了一個有 8 年歷史的開源金融撮合引擎(exchange-core),修改 4,000 行以上程式碼,超過 1,000 次工具呼叫,吞吐量提升 185%。
這類演示很難從外部獨立驗證(Moonshot 自己跑的),但它提供了一個「長程任務失敗點」的參照——K2.5 在 12 小時以上的任務中工具呼叫準確率會開始衰退,K2.6 在同樣時長內維持穩定。
開源的真正含義
K2.6 是開源模型(MoE 架構,模型權重可下載),API 也開放外部調用。這意味著對於預算敏感的開發者,它提供了一個接近或超越部分閉源模型 coding 能力的選項,且 API 成本顯著更低。
Moonshot 自稱 K2.6 的 API 成本約為 Claude Opus 4.7 的 88% 折扣。這個數字來自 Moonshot 自己的比較,需要根據實際使用場景驗證——吞吐量和品質都需要跑你自己的 workload 才算數。
但「一個 1 兆參數的開源模型,在 SWE-Bench Pro 上超過 GPT-5.4,並能在 12 小時內以 Zig 完成從零到優化的推理引擎」這件事本身,說明了中國開源 AI 實驗室在 coding 領域的真實競爭位置。