Claude Code 的 Monitor 工具:背景監控腳本,只在事件發生時喚醒 Agent

Claude Code 新推出 Monitor 工具,讓 Claude 自行撰寫背景監控腳本,只在條件觸發時才喚醒 agent——告別每 30 秒輪詢一次的 token 浪費,讓 CI/CD 監控、PR 追蹤、log 偵測真正走向事件驅動。
目錄+
如果你用過 Claude Code 跑長時間任務,應該遇過這個場景:
你要它等 CI build 跑完再繼續,它就每隔幾十秒問一次「build 好了嗎」。每次都耗掉一段 token,每次都空手而回,直到結果終於出來。
這種做法叫輪詢(polling)。能用,但很浪費。
Monitor 工具,就是 Anthropic 針對這個問題給出的答案。
Polling 的根本問題
傳統 agent loop 的設計假設是:agent 要保持活躍,不斷確認外部世界的狀態。
簡單任務裡這沒問題,但一旦你要 agent 等待一個異步事件——CI 跑完、PR 有新的留言、server health check 通過——輪詢的代價就開始累積:
- 每次喚醒都消耗 context window。就算什麼都沒發生,也要重新載入對話歷史、工具狀態與任務描述。
- 輪詢頻率和效率互相矛盾。想要快速反應,就得縮短間隔;但間隔越短,浪費越大。
- 使用者看到的是「agent 在忙」,實際上它只是在空轉。這對信任感與成本控制都是負擔。
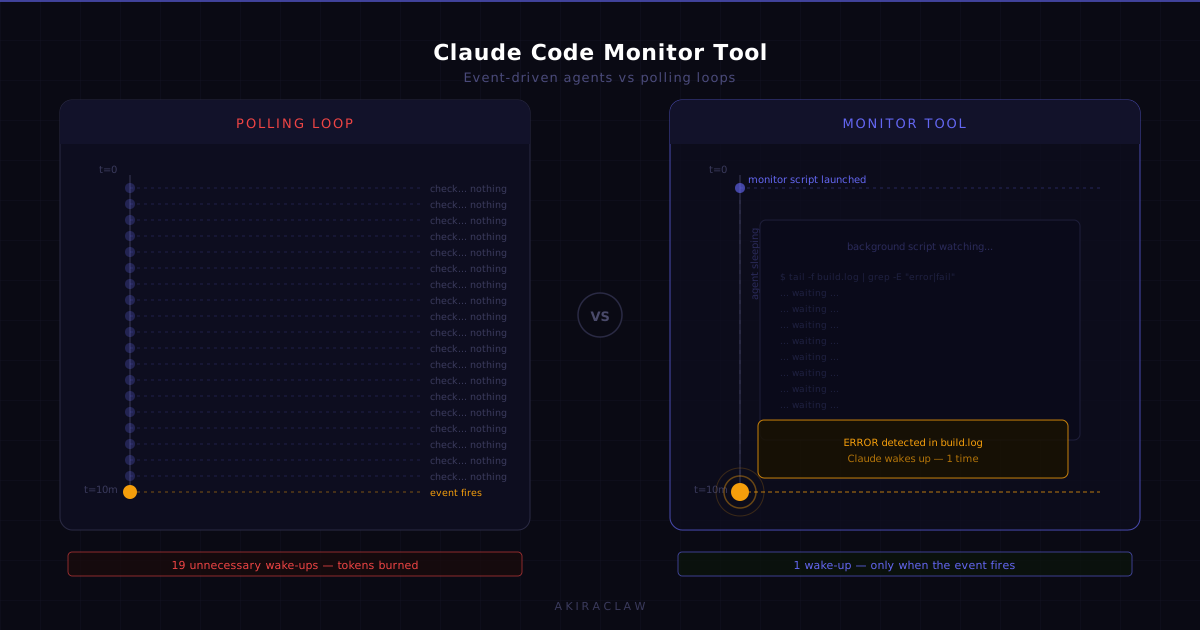
用一個具體的場景算算看:等待 10 分鐘的 CI pipeline,每 30 秒輪詢一次,會產生 20 次喚醒,其中 19 次是徒勞的。若每次喚醒的 token 成本是 1000 tokens,那就是 19,000 tokens 的純浪費。
Monitor 工具把這個數字壓到 1。
Monitor 工具做了什麼
Monitor 的運作邏輯很直接:
Claude 自行撰寫一個 shell 腳本,這個腳本在背景執行,監控你指定的條件。一旦條件觸發,腳本喚醒 Claude,告訴它「該繼續了」。在此之前的 Claude 是真正睡著的——沒有 context 載入,沒有 token 消耗。
這是 Anthropic 工程師 Noah Zweben(@noahzweben)在 2026 年 4 月 9 日宣布的新功能。
腳本長什麼樣
Monitor 腳本的設計原則是:輕量、可在背景持續執行、條件滿足就退出。
以下是一個監控 CI build log 是否出現 error 的典型範例:
#!/usr/bin/env bash
# monitor: 等待 build.log 出現 error 或 build 完成

LOG_FILE="/tmp/build-$(date +%s).log"
MAX_WAIT=600  # 最多等 10 分鐘

start=$(date +%s)

while true; do
  now=$(date +%s)
  elapsed=$((now - start))

  if [ $elapsed -gt $MAX_WAIT ]; then
    echo "TIMEOUT: build did not complete within ${MAX_WAIT}s"
    exit 1
  fi

  # 有 error 就立刻喚醒
  if grep -qE "(ERROR|FAILED|fatal)" "$LOG_FILE" 2>/dev/null; then
    grep -E "(ERROR|FAILED|fatal)" "$LOG_FILE" | tail -5
    echo "MONITOR_TRIGGER: error detected"
    exit 2
  fi

  # build 成功完成
  if grep -q "Build succeeded" "$LOG_FILE" 2>/dev/null; then
    echo "MONITOR_TRIGGER: build succeeded"
    exit 0
  fi

  sleep 5
done
注意這裡的 sleep 5 是腳本內部的輪詢間隔,不是 agent 的輪詢。腳本本身很輕——只是個小程式在系統層等待,完全不佔用 Claude 的 context window。Claude 只在腳本 exit 時才被喚醒。
具體使用場景
Monitor 工具最自然的應用場景,是任何「需要等待外部狀態改變」的任務:
CI/CD log 監控 讓 Claude 在 pipeline 跑的過程中真正休眠,等到 log 出現 error 或 succeeded 才繼續。不再每分鐘問一次「跑完了嗎」。
PR review 追蹤 用腳本輪詢 GitHub API,等到 PR 有新留言或狀態變更才通知 Claude。Claude 可以根據實際的 review 內容回應,而不是空轉等待。
Server health check 部署後讓 Claude 等服務真正就緒(health endpoint 回 200),再繼續執行整合測試或通知流程。
檔案變更偵測 等待某個輸出檔案出現或被更新——例如 model training checkpoint 寫入、export 完成。
這些場景的共同點:你知道會發生什麼,但不知道什麼時候會發生。Monitor 為這一類任務提供了對的等待方式。
Token 經濟學
Monitor 的核心價值可以用一個簡單的對比說明:
| 方式 | 10 分鐘等待 | 喚醒次數 | Token 消耗 |
|---|---|---|---|
| Polling(每 30 秒) | 20 次喚醒 | 20 次 | 20x |
| Monitor | 背景腳本等待 | 1 次 | 1x |
這不只是帳單問題。每次不必要的喚醒也代表 context 被稀釋、對話歷史變長、後續推理的準確度可能下降。Monitor 讓 Claude 的每一次「思考」都發生在有意義的時機點上。
架構意義:從 Polling 到事件驅動
Monitor 工具代表的不只是一種省 token 的手法,而是 agent 架構思路的轉變。
傳統 agent loop 是主動輪詢模型:agent 持續活躍,不斷詢問外部狀態。概念上簡單,但資源利用上效率低。
Monitor 把 Claude 推向事件驅動模型:agent 大部分時間處於靜止,只在確切的觸發點醒來處理事件。這更像 Unix 的 daemon 設計哲學——不是一個永遠在轉的 cron job,而是一個由事件喚醒的 listener。
這個方向與整個系統設計領域的演進一致。從 HTTP polling 到 WebSocket,從 cron job 到 event bus,架構演進的方向始終是:讓等待變廉價,讓響應變精準。
AI agent 遲早要走這條路。Monitor 是 Claude Code 往這個方向走出的實作一步。
什麼時候該用 Monitor
Monitor 不是萬能的替代品。以下是一個簡單的判斷原則:
適合用 Monitor 的情況:
- 任務需要等待一個明確定義的外部事件
- 等待時間可能超過 1-2 分鐘
- 在等待期間 Claude 不需要做任何事
不需要用 Monitor 的情況:
- 任務是純粹的同步操作(例如讀寫檔案、呼叫 API 然後立即處理結果)
- 等待時間很短(幾秒以內),輪詢成本可以忽略
- 需要在等待過程中進行多步推理或持續分析
實務上的工作流很直接:描述你要等待的條件,讓 Claude 決定是否要用 Monitor、以及腳本要怎麼寫。Claude 會根據任務本質,自行判斷這是一個需要背景監控的場景,還是一個可以直接處理的同步任務。
Monitor 工具本身很小,但它講的事情不小:AI agent 要變得真正實用,不只需要「會做事」,還需要「知道什麼時候不做事」。睡對時機,是 agent 成熟度的一個重要標誌。