
DGX Spark vs RTX 5090:容量與記憶體頻寬比較
DGX Spark 的 128GB 與 RTX 5090 的 32GB 該怎麼比較?本文整理 273GB/s、1,792GB/s 的頻寬差異,估算 70B 量化模型的記憶體需求,並列出比較本地 LLM 速度時必須固定的測試條件。

最後更新:
目錄+
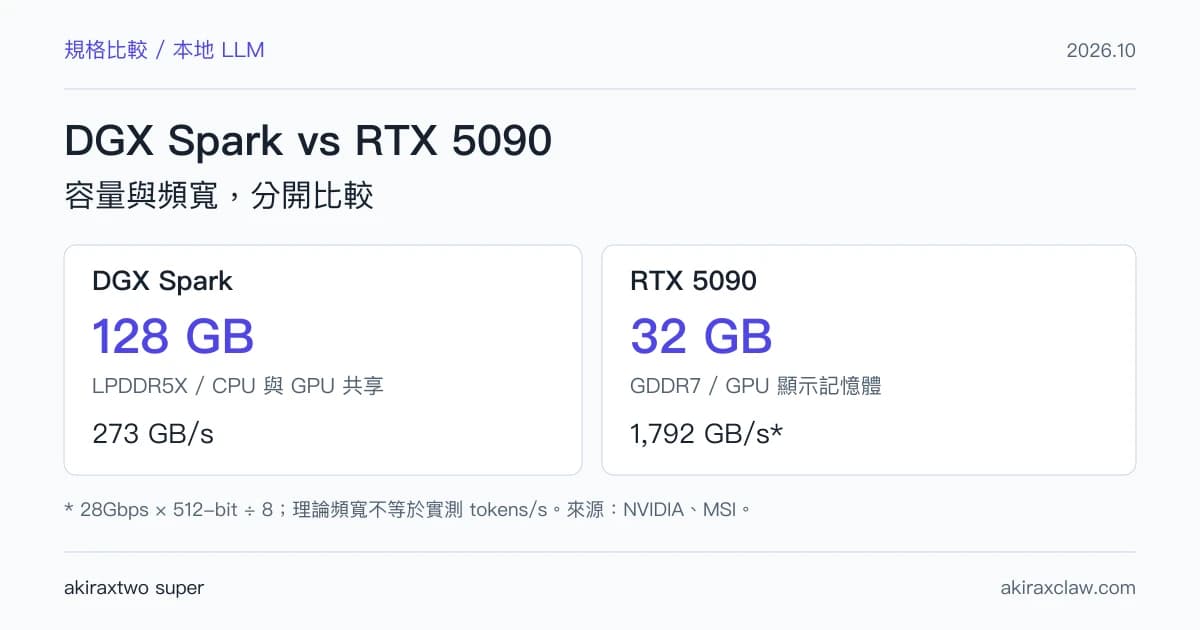
DGX Spark 與 RTX 5090 的差別,先看兩件事:模型能否完整放入記憶體,以及工作負載能多快完成。128GB Spark 提供較大的共享記憶體;RTX 5090 的 32GB GDDR7 則有較高的理論頻寬。兩個數字不能直接換成推理速度排名。
本文依 2026 年 10 月 28 日查核的官方規格更新,沒有把紙面頻寬當成 tokens/s 實測。若還沒分清 Spark、Station 與機櫃產品,可先看 NVIDIA DGX 產品線與價格查詢。
DGX Spark vs RTX 5090 規格對照
| 比較項目 | DGX Spark,本文採 128GB 版 | GeForce RTX 5090 桌上型顯示卡 |
|---|---|---|
| 記憶體容量 | 128GB,CPU 與 GPU 共享 | 32GB,GPU 顯示記憶體 |
| 記憶體類型 | LPDDR5X | GDDR7 |
| 記憶體介面 | 256-bit | 512-bit |
| 記憶體頻寬 | 273GB/s | 1,792GB/s,依規格換算 |
| 採購單位 | 含 CPU、儲存與系統的整機 | 顯示卡,需搭配主機 |
Spark 資料來自 NVIDIA DGX Spark 規格;RTX 5090 的 32GB 容量可查 NVIDIA 產品頁。MSI GAMING TRIO 規格表列出 28Gbps 與 512-bit,因此理論頻寬為 28 × 512 ÷ 8 = 1,792GB/s。
NVIDIA 目前也列出由部分合作廠商提供的 64GB Spark。詢價或看測試時,先確認是 64GB 還是 128GB;本文不把不同容量版本混在一起。
128GB 能放下模型,不代表輸出速度較快
容量不足時,模型可能無法載入,或需要把部分資料卸載到其他記憶體。容量足夠之後,頻寬、運算能力、核心實作與工作負載才一起決定速度。
以權重讀取量大的逐字生成工作為例,搬移資料的速度會影響延遲;但首段輸入處理、多人批次服務和不同模型架構,未必有相同瓶頸。因此 1,792 ÷ 273 ≈ 6.56 只能解讀成理論頻寬比例,不能宣稱 RTX 5090 的推理速度快 6.56 倍。
Station 的 748GB 又是另一種配置,包含不同頻寬的記憶體區域。若要比較更大容量,可接著讀 DGX Station 的 748GB 記憶體拆解,不要把總容量當成全數高速 GPU 記憶體。
跑 70B 量化模型,要留多少記憶體?
先做一個可重算的容量估算:假設 700 億個參數都用 4-bit 儲存,權重資料約為 70 × 10⁹ × 4 ÷ 8 = 35 × 10⁹ bytes,也就是 35GB,約 32.6GiB。
這還沒計入量化附加資訊、KV cache、執行時工作區,以及系統占用。所以上述模型不能假設會完整放入 RTX 5090 的 32GB;同樣地,也不能保證任何 48GB 卡都能應付所有 70B 模型、長上下文與多人並行設定。
實際評估時,記下模型檔案大小、量化格式、預計上下文長度與同時請求數,再用目標引擎確認峰值記憶體。這份估算是容量檢查起點,並非相容性或效能測試結果。
比較本地 LLM 速度,先固定這五項條件
- 模型與版本:同一份權重、相同量化格式,避免拿不同模型的結果比較。
- 推理軟體:記錄引擎、驅動與核心版本,並確認支援對應硬體。
- 輸入與輸出長度:相同提示內容、上下文長度與生成上限。
- 使用方式:單人對話與多人批次服務分開測;記錄 batch size。
- 記憶體配置:標註是否完整載入 GPU/共享記憶體,以及是否卸載到 CPU 或磁碟。
結果至少分開記錄首字延遲、後續輸出 tokens/s、峰值記憶體與整機耗電。若比較的是整機成本,也要把 RTX 5090 所需的 CPU、電源與其他主機零件算進去。
要處理的模型超過單卡容量時,Spark 的大容量值得進一步測試;模型已能完整載入時,則應直接比較目標任務的速度。這比用「128GB 一定比較快」或「消費卡一定贏」作為採購依據更有用。
常見問題
DGX Spark 記憶體頻寬是多少?
NVIDIA 公布的 DGX Spark 記憶體頻寬為 273GB/s。本文比較 128GB LPDDR5X 版本;容量與頻寬是兩個不同指標。
RTX 5090 的記憶體頻寬是多少?
以 MSI RTX 5090 GAMING TRIO 的 28Gbps 記憶體速度、512-bit 介面計算,理論頻寬為 1,792GB/s,約為 Spark 的 6.56 倍;這不等於 LLM 吐字速度快 6.56 倍。
32GB RTX 5090 能完整放入 70B 的 4-bit 模型嗎?
若 700 億個參數都以 4-bit 儲存,光權重就約需 35GB,尚未加入量化資訊、KV cache 與執行時開銷,因此不能假設可完整放入 32GB 顯示記憶體。
DGX Spark 一定比 RTX 5090 慢嗎?
不能只看規格下結論。必須固定模型、量化格式、推理引擎、上下文長度與批次大小,並確認是否發生記憶體卸載,再比較首字延遲和輸出 tokens/s。本文沒有提供兩台機器的實測排名。