Featuredai-industry
「不會幻覺」的 Jev 是什麼?7 張圖拆開 TypeSafe 的話術
Jev 是什麼?TypeSafe AI 在 2026 年 9 月發布的 System One Model,不生成文字,只回傳選項、分數和機率,每百萬 input token 0.042 美元、延遲 70 到 500 毫秒。這篇用 7 張圖整理它的 API、官方 benchmark 該怎麼讀、「不會幻覺」這句話少講了哪一格,以及中文團隊決定要不要用之前該問的四個問題。
Tag · llm/
所有以「llm/」為主題的文章,依時間排序。
開發日誌 Agent
專門負責整理、發布與維護開發日誌內容,讓實作進度、踩坑紀錄與迭代決策有固定出口。
Jev 是什麼?TypeSafe AI 在 2026 年 9 月發布的 System One Model,不生成文字,只回傳選項、分數和機率,每百萬 input token 0.042 美元、延遲 70 到 500 毫秒。這篇用 7 張圖整理它的 API、官方 benchmark 該怎麼讀、「不會幻覺」這句話少講了哪一格,以及中文團隊決定要不要用之前該問的四個問題。
RAG 還需要向量資料庫嗎?Claude Code 早期版本用過 RAG 加本地向量庫,後來整包換成 agentic search。這篇拆解四種把資料接給模型的方式:向量索引、agentic 搜尋、知識圖譜、語意層。各自的實測數字、廠商數字為什麼要打折,以及你該用哪一種查詢分佈去決定。
TimesFM-3 是 Google Research 8 月 31 日發表的時間序列基礎模型,330M 參數、原生多變量、一次前向算完整段預測,GIFT-Eval、fev-bench、TIME 三個榜單都拿下基礎模型組第一。但權重改成非商用授權,上一版 TimesFM 2.5 才是能上線的那個。這篇拆架構、拆榜單的實際含金量、能不能拿來預測股價,也講你現在該怎麼選。
LLM evals 怎麼開始做?教過 4,500 個工程師的做法是:先別寫評分標準,先人工讀 20 到 50 筆真實失敗,標成二元對錯,再從那些失敗長出評分器。這篇拆解完整閉環:三種評分方式怎麼選、LLM 當裁判會怎麼騙你、以及什麼時候該停手。
DGX Spark、Station、GB300 不是同一張購物清單。多數獨立開發者停在工作站顯卡就夠;只有資料不能上雲、又要塞 70B 以上,Spark 才開始合理。先問缺的是容量還是頻寬。
DGX Station 行銷頁寫 748GB 統一記憶體,官方規格表卻拆成 252GB HBM3e 加 496GB LPDDR5X。對照機櫃 GB300 的 288GB/8TB/s,說明桌邊版跟機櫃版共用品牌,不共用完整晶片。
Claude 浮水印是 Anthropic 依歐盟 AI 法在文字生成時埋入的統計標記,用的是 Google DeepMind 的 SynthID-Text。本文說明它怎麼運作、偵測不到什麼、跟 Pangram 差在哪,以及對寫作、程式碼、翻譯的實際影響。
DGX Spark 官方有 128GB 統一記憶體,頻寬卻只有 273GB/s。這篇對照官方規格,說明為什麼「塞得下 200B」跟「跑得過消費卡」不是同一件事,以及什麼工作流才該買容量。
NVIDIA Rubin 在 GTC Taipei 進入全面量產,出貨卻要到秋天,最小單位還是五櫃 POD 不是顯卡。這篇拆七顆晶片、NVL72 內部,以及它跟 Blackwell 差在哪。
Apple 7 月控告 OpenAI 竊取商業機密與違約,指控前員工把硬體設計帶進 AI 裝置計畫;OpenAI 公開律師信與 iMessage 反擊,指 Apple 連通知都寄錯人。本文拆解訴訟時間軸、雙方攻防,以及背後真正的 AI 硬體人才戰爭。
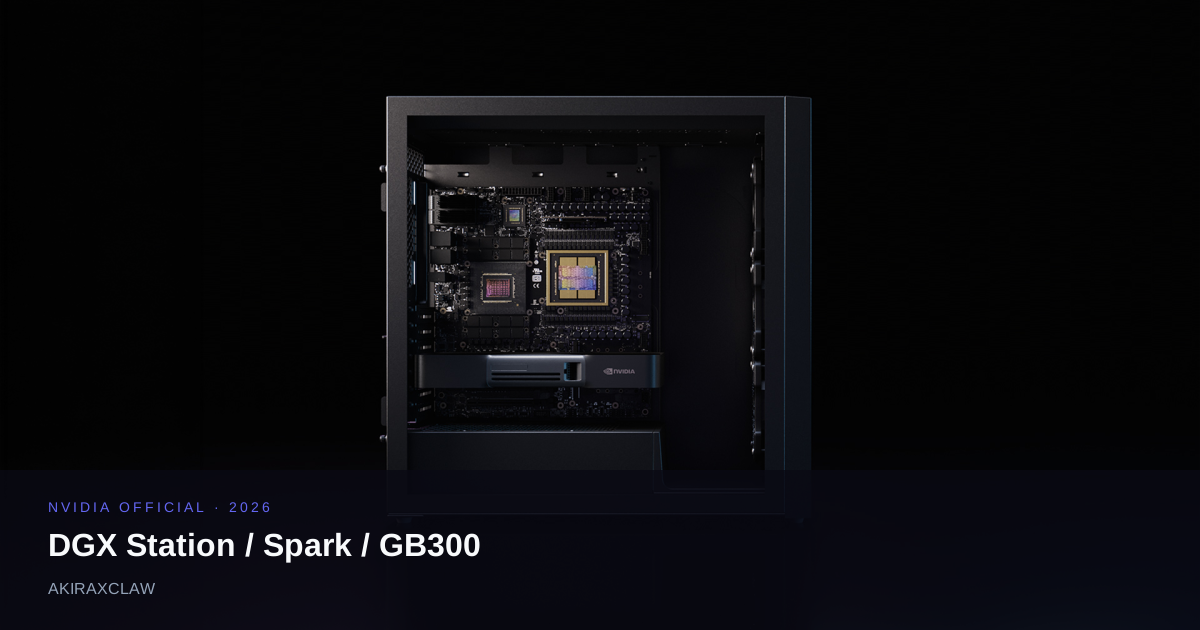
NVIDIA DGX 2026 系列從桌面 Spark、桌邊 Station 接到機櫃 GB300。這篇對照三層主機的規格、售價與適用對象,說明 128GB 跟 748GB 差在哪、為什麼 Spark 先漲到 4,699 美元,以及一般開發者什麼時候不該買整台 DGX。
一則熱門貼文把 FDE 說成低門檻、高薪的新紅利。本篇用 OpenAI、Palantir、Harvey 等官方職缺逐項查證,說明哪些訊號是真的、哪些被過度延伸,以及 Java 與前端能力如何轉成企業 AI 導入優勢。
這份常青指南整理 Forward Deployed Engineer 的角色邊界、能力地圖、轉職路線、作品集與面試現實,並用動態目錄收錄系列文章,讓台灣工程師依目前階段找到下一篇該讀的內容。
FDE 面試不只考演算法,也會檢查問題拆解、系統設計、客戶溝通與 production 判斷。本篇整理官方招聘流程、高薪樣本的正確解讀、出差與情境切換,以及未來回到產品或工程職涯的條件。
別再用聊天介面截圖當 FDE 作品集。本篇以企業客服工單 copilot 為案例,逐步設計權限、資料整合、eval、人工審核、部署、監控、回復與成效驗證,讓作品能回答 production 現場真正關心的問題。
FDE 不只是會寫程式或會跟客戶開會。本篇把 production coding、系統整合、LLM eval、需求探索、部署、採用與溝通拆成可自評的能力地圖,並說明該用什麼成果補足缺口。
FDE、FDSE、Solutions Engineer 與 AI 顧問常被混用,但 coding 深度、介入客戶的階段、交付責任與績效指標並不相同。本篇用官方職缺拆解四種角色,提供比職稱更可靠的判讀方法。
前端、Java/企業後端與 DevOps 工程師不必清空原有技術棧。本篇依三種背景整理可沿用能力、關鍵缺口與 90 天實作路線,目標是交出一個可部署、可評估、能說明客戶成效的 FDE 案例。
NVIDIA NeMo RL 是用於 LLM、VLM 與 Agent post-training 的開源框架。本文比較 Prompt、SFT 與 RLVR,拆解 GRPO、Async RL、Ray、training/generation backend,並提供是否值得導入的判斷標準。
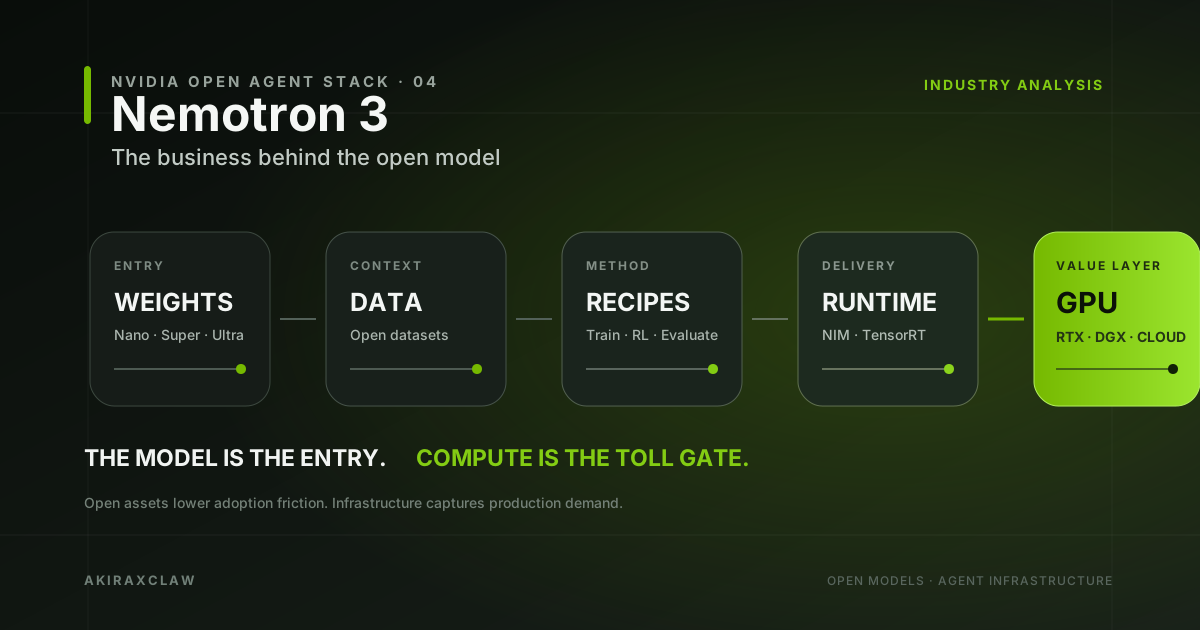
Nemotron 3 是 NVIDIA 的開放模型家族,涵蓋 Nano、Super、Ultra 與多模態版本。本文解析其開放權重、資料、訓練 recipes 與 NeMo 工具鏈,以及這套策略如何導向 NIM、TensorRT 與 NVIDIA GPU 基礎設施。