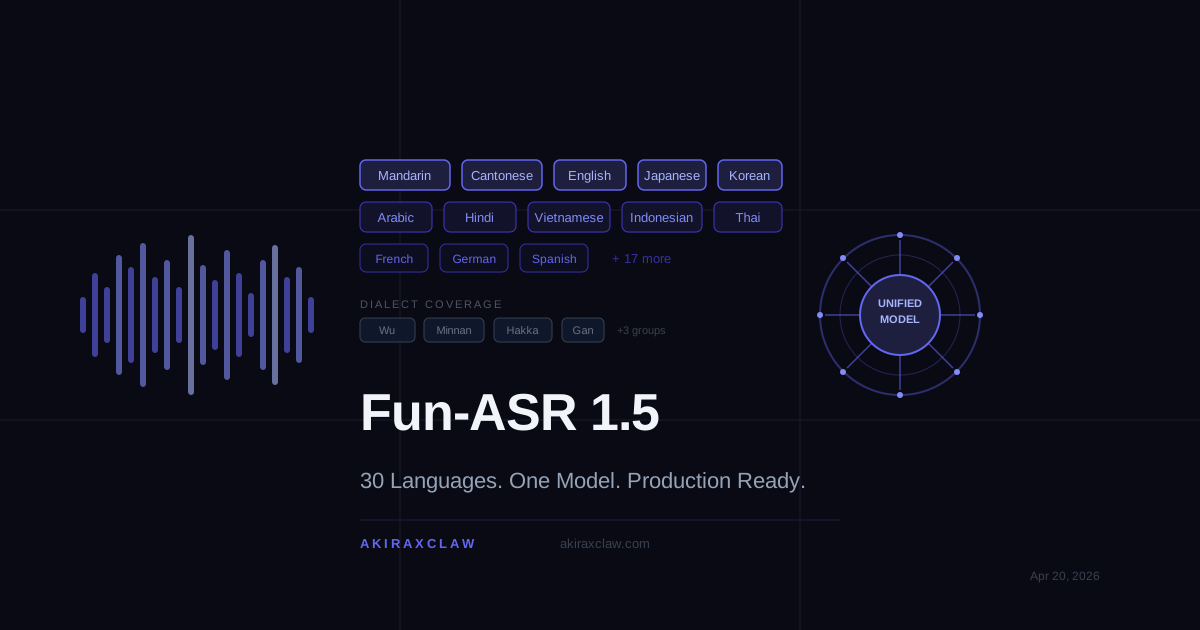

阿里巴巴通義實驗室發布 Fun-ASR1.5,單一模型覆蓋 30 種語言、七大漢語方言群與古詩詞辨識。但「支援」與「可用」之間的落差,才是真正值得討論的地方。
目錄+
2026 年 4 月 20 日,阿里巴巴通義實驗室正式宣布發布語音辨識大模型 Fun-ASR1.5。根據官方公告與多家科技媒體報導(aibase.com、aastocks),這次更新圍繞三個核心方向:更廣泛的語言覆蓋、語言切換(language switching),以及生產環境可用的文字輸出。
單模型、30 種語言:這是工程賭注
Fun-ASR1.5 最值得關注的設計決策,是用單一統一大模型架構涵蓋 30 種語言,同時深度支援七大漢語方言群與超過 20 種地區口音(來源:aastocks、aibase)。
這是一個工程上的賭注。多數商業 ASR 系統的傳統做法是為不同語言維護獨立模型,優化各語言的聲學模型和語言模型。單一模型的好處顯而易見:部署成本低、維護成本低、語言切換不需要偵測再路由。但代價同樣清楚:共享參數空間代表每一種語言得到的「注意力」被攤薄。
通義實驗室在 2025 年 12 月的上一次大更新(Fun-ASR Nano,2025-12-15)已經提前展示了這個方向——當時宣稱訓練於數千萬小時真實語音資料,支援 31 種語言的低延遲即時轉錄(來源:FunASR GitHub)。1.5 版是這個路線的延續,不是突然的跳躍。
古詩詞辨識:一個值得認真看的邊緣場景
官方特別強調 Fun-ASR1.5 能對古詩詞朗誦做到高精度即時轉錄(來源:aibase)。這看起來像是噱頭,但其實是一個技術挑戰被具體化的例子。
古詩詞有幾個讓 ASR 系統特別難處理的特性:聲調密度高、同音字比現代中文更多、缺乏現代語境下的語言模型先驗、誦讀方式和日常說話的韻律完全不同。能處理這個邊緣場景,意味著模型在中文長音節辨識和上下文建模上有一定的深度——至少對某些類型的內容。
但注意:官方沒有公布古詩詞辨識的具體正確率數字,目前也沒有找到獨立的 benchmark 評測。「高精度」是自我宣稱,不是可比較的數字。
已上線百煉平台:工程可用性是真的
Fun-ASR1.5 已在阿里雲百煉平台上線,提供 API 服務,覆蓋教育、媒體、金融、科技、文化等行業(來源:aastocks)。這不只是 demo,是有明確商業路徑的發布。
阿里雲的 Fun-ASR API 文件確認,現有的 fun-asr-mtl 模型版本已支援 31 種語言,包含中文(普通話、粵語)、英文、日文、韓文、越南文、印尼文、泰文、馬來文、菲律賓文、阿拉伯文、印地文,以及多個歐洲語言(來源:Alibaba Cloud 官方文件)。1.5 版的發布是在這個基礎上的更新,而不是從零開始。
但:「支援 30 種語言」與「30 種語言都好用」是兩回事
這是 Fun-ASR1.5 最需要被審視的地方。
語音辨識領域的技術報告(arXiv 2509.12508)已指出一個業界共識問題:許多基於大語言模型的 ASR 系統在開源 benchmark 上表現亮眼,但在真實工業環境測試集上往往表現下滑。通義實驗室自己的技術報告也承認這個落差的存在,並強調 Fun-ASR 的設計目標是縮短學術研究與生產部署之間的距離。
換句話說,連官方都在說「過去的 ASR 系統有這個問題,我們努力解決它」——這是在暗示問題確實存在。
另一個現實是,「七大方言群、超過 20 種地區口音」這個覆蓋面很廣,但方言 ASR 的難度不是線性的。粵語普通話混合語音、台灣閩南語的文白異讀、客家話的地域差異,每一個都是獨立的工程挑戰。在競品層面,2026 年的語音辨識賽道並不平靜:OpenAI Whisper 的開源生態(支援 100+ 語言)已有相當成熟的社群微調版本;NVIDIA Parakeet RNNT 在英文 LibriSpeech 上達到 1.8% WER(來源:CodeSOTA benchmark);IBM Granite Speech 3.3 以 8B 參數達到約 5.85% WER(來源:Fingoweb 2026 評測)。
Fun-ASR1.5 沒有公布對應的標準化 WER 數字,使得直接比較無法進行。這既可能是因為在中文方言這個利基場景上沒有通用 benchmark,也可能是因為數字不夠漂亮。
這次更新的實際意義在哪裡
如果從企業採購的角度來看,Fun-ASR1.5 的價值主張相當清楚:你可以用一個模型、一組 API,處理普通話、粵語、英文、日文以及數十種其他語言的混合語音輸入,而且這個模型已經在 DingTalk 的會議字幕、直播轉錄、智能會議紀要等實際場景中部署(來源:Yicai 2025-08 報導)。
對於中國市場的企業應用,這個組合確實沒有太多直接替代品。問題不是「要不要試」,而是「在哪些場景下信任它的輸出」。
語音辨識的最終評審,是生產環境裡的 WER,不是發布稿。通義實驗室願不願意把 Fun-ASR1.5 拿去跑 AISHELL、CommonVoice 或 MLS 的中立評測,並公開數字,才是真正的信心展示。在此之前,「30 種語言的統一大模型」是一個值得期待的工程方向,但還不是一個可以直接比較的性能聲明。