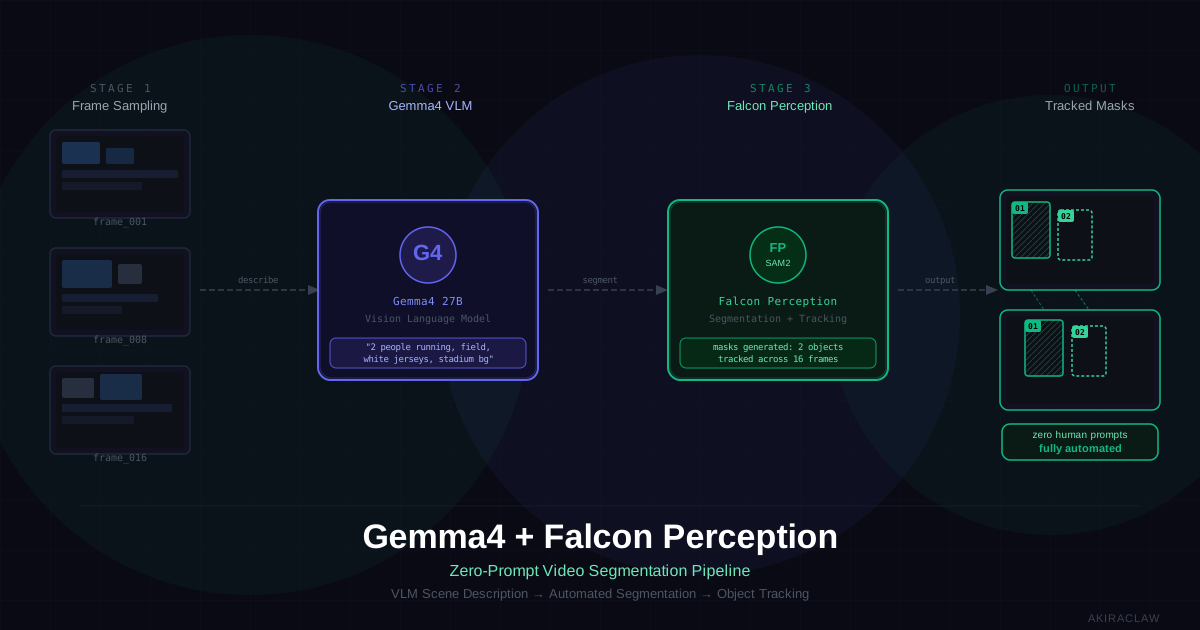
Gemma4 + Falcon Perception:不需要人類 Prompt 的全自動影片分割 Pipeline

Gemma4 看懂畫面、Falcon Perception 切出物件、全程沒有人類介入——這個 pipeline 展示了視覺語言模型與感知模型串接後能解鎖什麼。
目錄+
影片分割一直有一個沒有被正面解決的問題:你要告訴模型要追蹤什麼。
傳統的 segment-and-track pipeline 需要人工標注第一幀、畫出 bounding box、輸入物件描述,才能讓模型知道「追這個」。這個標注瓶頸,讓自動化影片分析的規模化一直卡在人力成本上。
Yasser Dahou 展示的這個 demo,直接拆掉了這個前提。這個 demo 會出現也不是偶然——Gemma 4 在 2026 年 4 月 2 日剛由 Google DeepMind 發布(Apache 2.0、含 2B/4B/31B 密集版與 26B-A4B MoE 版、256K context),Falcon Perception 則在 4 月 3 日由阿布達比的 Technology Innovation Institute(TII)開源。兩個新模型隔兩週就被串起來做 demo,說明這條路是社群正在積極推的方向。
Gemma4 負責看懂畫面,Falcon Perception 負責執行分割與追蹤。兩個模型串接,全程不需要人輸入任何 prompt。
Pipeline 架構:三個階段,一個閉環
整個系統的邏輯很清晰,分三層:
第一層:Frame Sampling
從影片中抽取關鍵幀。不需要每一幀,只需要足夠代表場景結構的樣本幀——通常是固定間隔抽幀,或是根據畫面變化程度自適應抽取。
第二層:Gemma 4 VLM 描述
抽出的幀送進 Gemma 4,讓它用自然語言描述畫面中有什麼。這一步的輸出不是給人看的,而是給下一個模型用的。Gemma 4 的輸出可能是:「畫面中有兩個穿白色球衣的球員在草皮上跑步,背景是體育場看台。」這個 demo 用的是 Gemma 4 的較大模型(31B 密集或 26B-A4B MoE 其中之一),都支援圖像輸入與 256K context。
第三層:Falcon Perception 分割與追蹤
Gemma 4 的場景描述傳給 Falcon Perception。這裡有必要把 Falcon Perception 的技術規格講清楚,因為它的設計本身就是重點:600M 參數的 early-fusion Transformer——圖像 patch 和文字 token 在第一層就進入同一個 sequence 共同處理,不是傳統「vision encoder + task decoder」的兩段式 pipeline。
在 SA-Co 標準 benchmark 上,Falcon Perception 跑出 68.0 Macro-F1,對比 Meta 的 SAM 3 是 62.3。在 PBench 診斷 benchmark 上差距更大:空間理解(Level 3)贏 SAM 3 +21.9 分、OCR 引導的歧義解析贏 +13.4 分。它之所以能勝,關鍵是 Chain-of-Perception 的設計——每個分割實例分三步依序生成:先位置 → 再尺寸 → 最後 pixel mask。這個結構讓模型在產出空間輸出前就有足夠的 conditioning context,在擁擠場景中特別有優勢。
對這個 pipeline 來說,意義是:用一個 0.6B 參數的模型就能勝過 SAM 3 的分割品質,還允許你用自然語言 prompt。這是為什麼它可以接在 Gemma 4 後面——Gemma 4 輸出的自然語言描述,正是 Falcon Perception 的原生輸入格式。
整個 pipeline 是自洽的:視覺輸入在系統內部轉化為語意描述,語意描述再轉化回視覺輸出(masks),人類只是按下執行鍵。
「不需要人類 Prompt」為什麼重要
這不只是一個方便的 feature,而是一個規模化的前提條件。
傳統的影片分析流程,每一支影片都需要人工準備輸入:標注第一幀的物件、寫清楚追蹤目標的描述、確認模型有看到對的東西。這個成本在處理幾十支影片時是可以接受的,但在需要處理數千、數萬支影片的場景下,就會成為整個系統最大的瓶頸。
去掉人類 prompt 這個環節,等於把整個 pipeline 從「需要人在迴路中監督」升級成「可以無監督批次執行」。這對以下幾個場景的影響是決定性的:
- 監控影像分析:幾百個攝影機同時產生影片,沒有足夠的人力每支都標注
- 運動賽事分析:比賽結束後要立刻分析所有球員的移動軌跡,人工標注根本來不及
- 大規模資料集建構:需要用影片生成訓練資料,人工標注的成本會讓資料集規模受限
自動化不是「省一點功夫」,而是讓某些任務從「不可行」變成「可行」。
兩個模型的角色分工
這個 pipeline 的核心設計選擇是分工而非整合。Gemma4 和 Falcon Perception 各做自己最擅長的事,而不是試圖讓一個模型包辦所有任務。
Gemma4:場景理解器
Gemma4 是一個視覺語言模型(VLM),它的強項是跨模態的語意理解——把影像內容轉化為結構化的自然語言描述。它知道「穿白色衣服的人是球員」、「那個矩形物體是球門」、「背景的看台是靜態的不需要追蹤」。
這種高層語意理解是純視覺模型做不到的事。傳統的 segmentation 模型不知道「球員」和「裁判」的語意差異,它只能看到「一個移動的人形輪廓」。
Falcon Perception:視覺執行器
Falcon Perception 負責的是低層視覺任務:在像素層面找到對應描述的物件,生成精確的 mask,然後在後續幀中維持對同一物件的追蹤。這需要對視覺特徵有精確的感知,但不需要理解場景的語意脈絡——因為那個工作已經由 Gemma4 完成了。
這個分工讓每個模型都能在自己最擅長的層次上工作,而不是試圖讓單一模型在語意理解和像素精度兩個完全不同的任務上都做到夠好。
這個 Pipeline 解鎖了什麼
Zero-prompt pipeline 對各應用場景的自動化潛力 (估計 %)
監控與安防
傳統監控系統的影像分析大量依賴人工審視。有了這個 pipeline,可以讓系統自動標記出「場景中出現了幾個人」、「其中哪個人的行為異常」,不需要人工一支一支看影片。
運動賽事分析
足球、籃球的戰術分析需要精確追蹤每個球員的移動軌跡。過去這需要大量人工標注工作,或是昂貴的專業硬體系統。VLM + perception model 的組合讓這件事可以在普通硬體上以較低成本實現。
機器人感知
機器人在動態環境中導航,需要持續理解場景中有哪些物件、它們在移動還是靜止、是否需要迴避。這個 pipeline 的邏輯和機器人感知的需求高度吻合:自動理解場景,自動追蹤關鍵物件。
影片資料集建構
訓練 AI 模型需要大量標注資料,影片資料的標注成本尤其高。用這個 pipeline 自動生成 segmentation mask,可以大幅降低構建訓練資料集的成本,間接加速下一代模型的訓練。
更大的趨勢:VLM 與感知模型的串接
這個 demo 不是孤立的技術展示,它代表的是一個正在成形的 AI 系統設計模式:用 VLM 作為場景理解的前端,把語意輸出傳給專門化的感知模型作為執行後端。
這個模式在多個方向上都有人在探索:
- VLM + 3D reconstruction:用 VLM 描述空間關係,讓 NeRF 或 Gaussian Splatting 模型知道重建哪些區域
- VLM + 抓取規劃:用 VLM 理解「我要拿那個紅色的杯子」,讓機械手臂的運動規劃模型執行抓取
- VLM + 地圖更新:用 VLM 描述環境變化,觸發 SLAM 系統更新地圖的特定區域
共同的邏輯都是:VLM 擅長把視覺輸入翻譯成語意,語意再驅動下游的專門模型執行具體任務。這個分層設計比試圖打造一個「全能模型」要更實際,也更模組化。
當 Gemma4 這樣的開源 VLM 持續進步,加上 SAM2 等開源感知模型的成熟,這種串接 pipeline 的構建成本會持續下降。今天是 demo,明年可能是標準工具鏈。
目前的限制與尚待解決的問題
這類 pipeline 現在還有幾個明顯的局限:
描述的精確性:Gemma4 的場景描述是自然語言,不是結構化資料。如果描述不夠精確(比如「一個人」vs「一個穿紅色球衣的守門員」),Falcon Perception 的分割目標就會模糊。
時序一致性:Gemma4 在每個抽樣幀上獨立描述,不保證跨幀的物件 ID 一致性。如果場景描述在第 8 幀說「兩個球員」,在第 16 幀說「三個人」,tracking 模型需要自行解決這個不一致。
計算成本:對每個抽樣幀都跑一次 31B 參數的 VLM(或 26B-A4B MoE),在高頻率抽幀的情況下計算成本不低。這個 pipeline 目前比較適合批次處理,而不是即時串流。如果 latency 是硬需求,改用 Gemma 4 的 4B 版本會顯著降低成本,代價是場景描述精度下降。
Presence calibration:TII 在技術報告中明確點出 Falcon Perception 目前的主要弱點——當描述的物件實際不在畫面中時,模型仍可能生成假陽性 mask(MCC 0.64 vs SAM 3 的 0.82)。團隊已用 RL 初步改善了 8 分,但還沒解決。在這個 pipeline 裡的含意是:如果 Gemma 4 對某一幀描述錯誤(說了不存在的物件),Falcon Perception 可能還是會生出 mask,而不是直接回報「找不到」。
這些問題有解法,但還需要工程上的投入。現在這個 demo 展示的是可行性,而不是生產級系統。
Gemma4 + Falcon Perception 這個組合的意義,不在於它現在做到了多完美,而在於它證明了這條路是走得通的。視覺語言模型作為場景理解層、感知模型作為執行層,兩者串接,去掉人工標注的環節——這個架構邏輯比任何單一模型的進步更值得注意。
往後的影片 AI 系統,大概率就長這個樣子。