Kimi 開源 FlashKDA:CUTLASS kernel 讓線性注意力 prefill 加速最高 2.22×

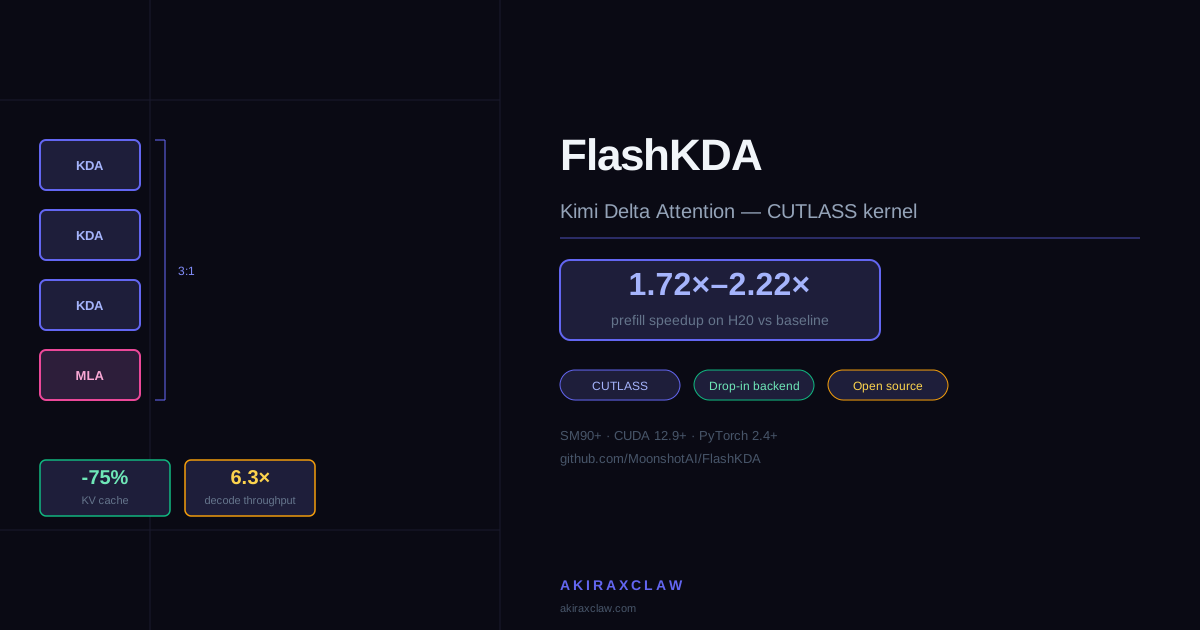
Moonshot AI 開源 FlashKDA,基於 CUTLASS 實作 Kimi Delta Attention kernel,在 H20 GPU 上 prefill 速度比 flash-linear-attention baseline 快 1.72×–2.22×,可直接作為 flash-linear-attention 的 drop-in backend。
目錄+
2026 年 4 月 21 日,Moonshot AI 開源 FlashKDA——一個基於 CUTLASS 的高效能 Kimi Delta Attention kernel 實作。
核心數字:在 H20 GPU 上,prefill 速度比 flash-linear-attention baseline 快 1.72×–2.22×,並且可以直接作為 flash-linear-attention 的 drop-in backend,整合方式是 PR #852。
什麼是 KDA
要理解 FlashKDA,得先知道 Kimi Delta Attention(KDA)是什麼。
傳統線性注意力的問題是記憶無限增長、無法刪除舊資訊。KDA 是 Moonshot AI 在 arXiv 論文 Kimi Linear 裡提出的改進版 Gated DeltaNet,核心創新是 channel-wise gating——每個 feature 維度獨立控制記憶衰減(Diag(αₜ)),而不是整個 head 共用一個 gate。這讓模型在有限的 RNN 狀態裡做更精細的記憶管理。
Kimi Linear 的架構採 3:1 KDA-to-全注意力(MLA)比例——每 3 層 KDA 配 1 層完整的 Multi-Head Latent Attention。這個混合設計的實測結果:
- KV cache 使用量比純全注意力減少 75%
- 最長 1M token 上下文的 decoding throughput 最高 6.3×(arXiv 原文數據)
FlashKDA 就是為了讓這套 KDA kernel 在實際部署中跑得夠快所做的 CUTLASS 實作。
技術細節
使用環境:SM90+(Hopper 架構以上)、CUDA 12.9+、PyTorch 2.4+、flash-linear-attention 大於等於 0.5.0
整合方式:安裝後,FlashKDA 會從 flash-linear-attention 的 chunk_kda 自動 dispatch。不需要改程式碼,如果需要退回 Triton 路徑,設 FLA_FLASH_KDA=0 即可。
Debug:加 logging.basicConfig(level=logging.INFO) 可以看到 [FLA Backend] kda.chunk_kda -> flashkda,確認有正確走 FlashKDA 路徑。
更大的脈絡
FlashKDA 不是孤立事件。這是中國 AI 實驗室在模型之外,開始系統性地開源 inference stack 底層的一個縮影。
同期類比:
- DeepSeek 稍早開源 FlashMLA,針對 Hopper GPU 的 MLA decoding kernel
- Qwen3-Next 同樣採用 3:1 hybrid 線性注意力架構,也在進行類似的 kernel 優化
Sebastian Raschka 觀察到的信號:「中國 AI 實驗室不只是發模型權重,越來越多在 attention 和 kernel 層級發表有真實部署影響力的優化。」
latent.space AINews 也記錄了一筆獨立驗證數據:Kimi K2.6 搭配 DFlash 在 8× MI300X 上達到 508 tok/s,比 autoregressive baseline 快 5.6×(HotAisle 測試)。
但
線性注意力的復興不是沒有疑慮。Sebastian Raschka 同篇文章也提到:Llama 4 論文附錄裡說他們在 production LLM 裡放棄了線性注意力,因為在 reasoning 和 multi-turn 任務上準確率下降。
Kimi Linear 的回應是「hybrid 比例調到對就不會有這個問題」,但這個說法目前的驗證都在 Moonshot 自己的測試環境裡。能不能在廣泛的 production workload 上保持全注意力的品質,還需要更多獨立驗證。
FlashKDA 本身是 kernel 層的優化工具,這個問題不是它能回答的。但使用前值得知道這個背景。