Nemotron 3 是什麼?NVIDIA 開放模型的真正生意

Nemotron 3 是 NVIDIA 的開放模型家族,涵蓋 Nano、Super、Ultra 與多模態版本。本文解析其開放權重、資料、訓練 recipes 與 NeMo 工具鏈,以及這套策略如何導向 NIM、TensorRT 與 NVIDIA GPU 基礎設施。
目錄+
如果一家公司的主要收入來自 GPU,它為什麼要公開足以讓別人修改、部署,甚至拿去做商業產品的模型?
只把答案歸因於「回饋社群」太輕,也不能反過來斷言每一份公開資產都是硬體綁定。比較接近現實的讀法是:Nemotron 3 不是一個孤立的 LLM 發布,而是 NVIDIA 把模型、資料、訓練與部署連成同一條 Agent 基礎設施路徑。
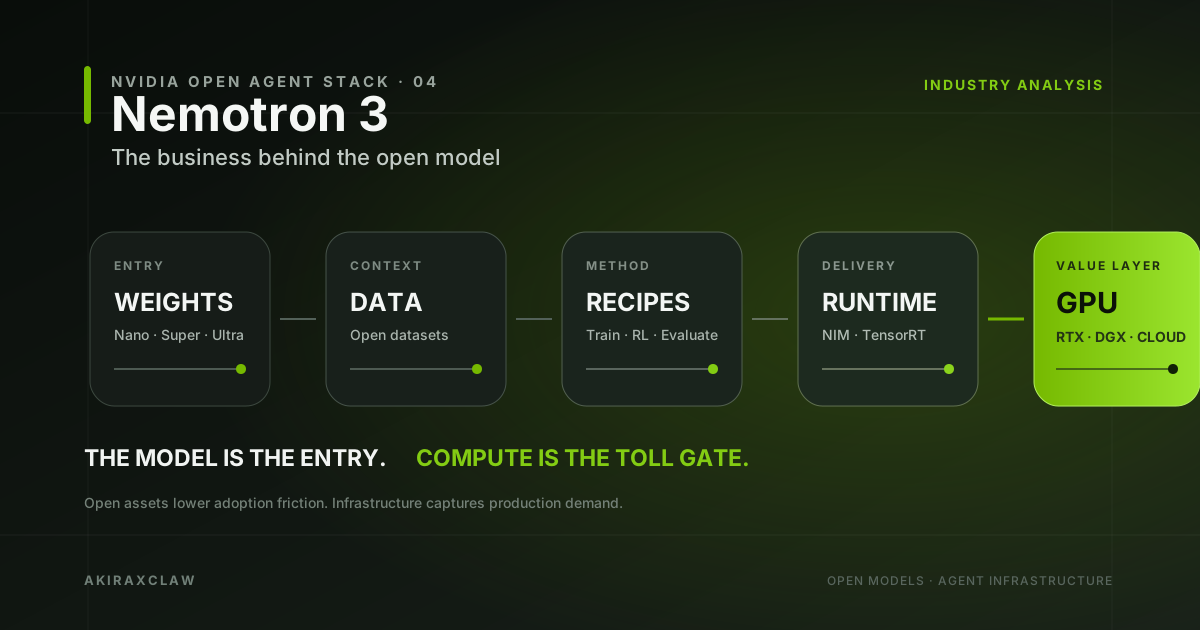
這篇文章先說清楚哪些是 NVIDIA 已公開的事實,再提出一個產業判斷:模型是入口,算力才是收費站。 這句話是本文對 NVIDIA 產品組合的分析,不是 NVIDIA 的官方口號。
Nemotron 3 是什麼?不是單一模型,而是一組 Agent 分工
NVIDIA Research 的 Nemotron 3 家族頁把產品分成 Nano、Super 與 Ultra;後續又加入能處理文字、圖片、影片與音訊輸入的 Nano Omni。它們共同面向 Agentic AI,但用途不該混為一談。
| 模型 | 官方標示規模 | 主要角色 | 比較合理的使用情境 |
|---|---|---|---|
| Nemotron 3 Nano | 31.6B 總參數,約 3.2B active,不含 embeddings | 輕量推理 | 資源受限、低延遲服務、小型 Agent 原型 |
| Nemotron 3 Nano Omni | 30B 總參數,約 3B active | 多模態感知與推理 | 需要同時理解文字、影像、影音與音訊的 Agent |
| Nemotron 3 Super | 120B 總參數,12B active | 正式環境的 Agent 推理 | 程式、企業工作流、多步驟工具使用 |
| Nemotron 3 Ultra | 550B 總參數,55B active | 長時間、高難度推理 | 深度研究、長流程 coding 與企業 Agent |
這些模型採用 Hybrid Mamba-Transformer MoE 路線,Super 與 Ultra 再加入 LatentMoE、多 token prediction 與 NVFP4 訓練等設計。家族最高支援一百萬 token context,但「支援」不等於任何硬體、任何 workload 都能用相同成本跑滿。
更重要的是產品分層。Nano 讓團隊先用較低成本驗證任務;Super 接正式推理;Ultra 處理更長、更難的工作。NVIDIA 不是只用一個旗艦模型搶榜,而是替不同算力預算安排入口。
NVIDIA 到底公開了什麼?
Nemotron 官方 repository不只有下載權重的連結。它把自己定位成 developer asset hub,內容包含模型、資料集、training recipes 與部署指南。若把「開放」拆成幾層,差異會比較清楚。
| 開放層次 | Nemotron 3 提供的內容 | 必須保留的界線 |
|---|---|---|
| 模型 | Nano、Super、Ultra 與延伸版本的權重 | 使用 Nemotron Open Model License,不等同所有資產都採 OSI 開源授權 |
| 資料 | pretraining、post-training、RL、多模態與安全資料集 | 官方訓練仍可能使用未公開資料 |
| Recipes | 合成資料、curation、訓練、RL 與評估路徑 | recipe 可檢查,不代表官方成績可逐項重現 |
| 軟體 | NeMo Curator、Data Designer、Megatron Bridge、NeMo RL 等 | 各 repository 與元件需分別確認授權及支援範圍 |
| 部署 | NIM、TensorRT、雲端與 NVIDIA 加速平台指引 | 這是官方最佳化路徑,不是授權上的唯一執行環境 |
這種做法和「放一個模型頁,讓大家下載 weights」不同。團隊可以查看資料怎麼生成與清理、post-training 怎麼接、RL 怎麼跑,再把模型送進部署層。前兩篇談過的 NeMo Gym Agent 訓練環境與 NeMo RL 強化學習框架,正好補上環境、verifier 與 training loop。
授權也值得說準確。NVIDIA Nemotron Open Model License授予重製、修改、散布與再授權等廣泛權利,而且是免授權費的商業友善條款。重新散布時須附上授權並保留與衍生作品相關的原始通知;若原作品含 NOTICE,還須在衍生作品的 Notice 中加入指定 attribution。它也不自動授予 NVIDIA 商標使用權。
因此,最穩妥的描述不是「所有東西完全開源」,而是:NVIDIA 提供開放權重,並搭配公開資料、recipes 與開源工具,組成可修改、可部署的開放模型生態。
公開 recipe,不等於完整可重現
這是 Nemotron 3 最容易被宣傳文案略過的一段。
官方 repository 明確提醒:只使用 open-source data 的 recipes,是用公開資料子集訓練;技術報告的 benchmark 則使用額外的 proprietary data,因此兩者結果會不同。換句話說,你能看到一條公開訓練路徑,不代表按下執行就會得到與官方 checkpoint 一樣的模型。
可以把它拆成四個問題:權重能不能拿到、資料能不能檢查、軟體能不能修改、結果能不能重現。Nemotron 3 在前三項提供的材料相當多,第四項仍有缺口。
這不等於公開資產沒有價值。企業不一定要從零重訓 550B 模型;更常見的需求是確認資料治理方式、改 post-training 流程、接自己的 verifier,或評估模型能否離線部署。公開 recipes 讓這些工作不必完全從黑盒 API 猜測。但若研究者要驗證官方 benchmark 的因果來源,就不能把「有 recipe」寫成「完全可重現」。
從模型到 GPU:NVIDIA 的開放生態飛輪
把 Nemotron 3 放回 NVIDIA 的產品線,就會看到一條比模型下載量更重要的路徑。
模型先降低試用門檻;資料與 recipes 降低客製化門檻;NeMo RL、NeMo Gym 等工具把訓練工作標準化;NIM 與 TensorRT 再把部署導向 NVIDIA 最熟悉的執行環境。最後,正式 workload 會產生更多整合、案例與硬體需求,反過來吸引下一批開發者。
這張圖刻意保留「其他 runtime 與硬體」的分支。Nemotron 的授權沒有要求只能使用 NVIDIA GPU,開發者也可能選擇 vLLM、llama.cpp 或其他硬體後端。開放模型的競爭壓力是真實存在的;NVIDIA 要贏,仍得證明自家路徑在效能、維運或總成本上更好。
為什麼 NVIDIA 比純模型 API 公司更敢開放?
以下是產業推論,不是 NVIDIA 對營收路徑的公開承諾。
對主要靠模型 API 收費的公司來說,模型權重被廣泛下載,可能直接把使用量從自家端點帶走。NVIDIA 的收入位置更下游:訓練需要 GPU,推論需要 GPU,企業部署還可能使用 DGX、RTX、雲端 NVIDIA instances、NIM 與支援服務。即使模型本身免費,工作負載仍要在某處執行。
這讓 NVIDIA 可以把模型當作市場擴張工具。模型越容易被客製化,企業越容易從概念驗證走到 production;production workload 越多,加速運算市場就越大。這也是「模型是入口,算力才是收費站」的真正含義:不是每個下載者都會付錢,而是開放模型擴大整條算力道路的車流。
NVIDIA 對開放模型、資料與工具的官方說法強調,這些資產會透過 GitHub、Hugging Face、雲端與 inference 平台分發,許多模型也會包成 NIM microservices,在 edge-to-cloud 的 NVIDIA 加速基礎設施上運行。官方談的是選擇、透明度與開發速度;把它解讀成硬體分發策略,則是本文根據這條產品鏈做出的分析。
NVIDIA 的護城河,不只是一張 benchmark 表
模型榜單變動太快,Nemotron 3 不需要每個分數都第一,才具有策略價值。
第三方 Artificial Analysis 對 Nemotron 3 Ultra 的測試認為它是當時表現領先的美國 open-weights 模型之一,但同一套評測中仍有 Kimi 等模型在綜合 intelligence 指標領先,Gemma 也在 coding 指標略高。Artificial Analysis 明確揭露這是與 NVIDIA 合作的發布前測試,速度資料來自 BlackBox AI 的 pre-release deployment;它適合視為一個第三方評測切面,而不是完全獨立或跨平台的永久定論。
NVIDIA 更難複製的優勢,是把模型接到硬體感知最佳化、企業分發與既有開發者工具:
- NIM 把模型包成較標準化的推論服務。
- TensorRT 與 NVFP4 把模型設計對齊自家硬體能力。
- NeMo 把資料、訓練、RL 與評估串成可交付流程。
- DGX、RTX、雲端夥伴與企業支援把同一套 workload 從工作站延伸到資料中心。
官方列出的 CodeRabbit、CrowdStrike、Cursor、Factory、ServiceNow 與 Perplexity 等採用者,是產品分發的證據,但仍屬 NVIDIA 發布的客戶案例,不能直接推導市場占有率。真正要觀察的是:這些公司是否持續把 Nemotron 用在正式流量,而不只是發布日的整合展示。
這套策略可能在哪裡失敗?
第一,開放模型市場的替代速度極快。DeepSeek、Qwen、Kimi、Gemma 與其他模型如果在品質、成本或部署自由度上更有吸引力,開發者不會因為 NeMo 文件完整就留下來。
第二,公開資產與官方模型之間的重現落差,可能削弱研究社群信任。NVIDIA 已揭露資料差異是好事,但若 recipes 長期無法接近官方模型的關鍵能力,「開放訓練路徑」就容易只剩參考價值。
第三,順暢的官方路徑也可能變成 NVIDIA-centric dependency。NIM、TensorRT、NVFP4 與特定 GPU 的整合越深,企業日後移轉 runtime 的成本可能越高。這不是禁止離開的硬鎖,而是工程與維運成本形成的軟鎖定。
第四,模型家族更新太快,也會增加選型、評估與 migration 成本。一個團隊若每次發布都重做 benchmark,省下的 API 費用可能又花在平台工程。開放權重提供控制權,卻不會自動替企業消除生命週期管理。
企業與開發者真正該問的問題
如果你是企業決策者,先別問「Nemotron 3 是否比所有閉源模型強」。應該問的是:資料能否留在你的控制範圍、任務是否需要長時間 Agent、團隊是否已依賴 CUDA、替代 runtime 是否做過驗證,以及升級模型時誰負責回歸測試。
如果你是開發者,先用 Nano 驗證工具呼叫、context 與 verifier,再決定是否需要 Super 或 Ultra。小模型失敗若源自環境設計,換成更大的 checkpoint 通常只會讓錯誤變貴。要理解 Agent 如何管理自己的 Harness,可延伸閱讀 NOOA Agent Harness 分析。
本地硬體也要務實看待。像 RTX PRO 4000 Blackwell 24GB 這類工作站卡,可作為較小模型、量化版本與本地原型的規格參考;它不能代表 Nemotron 3 Super 或 Ultra 的正式部署需求,更不該被寫成單卡就能完整運行整個家族。先測 workload,再決定買卡、租雲端或使用託管端點。
聯盟揭露:上方連結為蝦皮聯盟連結,若透過連結購買,我可能取得少量分潤,不影響你的價格與本文判斷。
常見問題
Nemotron 3 是開源模型,還是只有開放權重?
較精確的說法是開放模型生態。NVIDIA 公開模型權重,並釋出部分資料集、training recipes 與 Apache 2.0 軟體;模型使用的是 NVIDIA Nemotron Open Model License。不要把權重、資料與軟體一律寫成同一種「開源」。
Nano、Super 與 Ultra 應該怎麼選?
Nano 適合低延遲、小型與資源受限任務;Super 面向正式的 Agent 推理;Ultra 面向長時間、高難度流程。先看任務成功率、延遲、context 與總部署成本,再看參數量。
公開 recipes 能重現官方模型成績嗎?
不能預設可以。官方說明 open-data recipes 使用公開資料子集,技術報告另用了 proprietary data,所以結果會不同。recipes 提供可檢查、可修改的路徑,不是 benchmark 複製保證。
Nemotron 3 可以不用 NVIDIA GPU 嗎?
可以探索其他 runtime 與硬體,授權並未把執行環境鎖死。不過 NIM、TensorRT、NVFP4 與官方效能指南都會讓 NVIDIA GPU 成為摩擦較低的路徑。授權自由與工程便利要分開評估。
NVIDIA 開放模型後如何賺錢?
本文的推論是,收入重點在模型下游:訓練、客製化、推論、工作站、資料中心與企業支援。NVIDIA 沒有宣告每個 Nemotron 使用者都必須進入這條路,因此這是一個可被未來採用率與營收結構驗證的產業假說。
結論:Nemotron 3 是入口產品
Nemotron 3 最值得注意的地方,不是 NVIDIA 又多了一個模型名稱,而是它把 weights、資料、recipes、RL、部署與 GPU 放進一個連續故事。開放降低了企業的黑盒焦慮,也讓開發者更容易進入 NVIDIA 熟悉的 Agent 基礎設施。
對使用者而言,這份開放帶來真實控制權,卻不保證完整可重現,也不會消除供應商依賴。對 NVIDIA 而言,如果模型逐漸商品化,最稀缺的就不再只是權重,而是能把模型穩定訓練、部署、監控並大規模運行的算力與軟體系統。
下一個值得追蹤的問題因此不是「下一版又贏了幾分」,而是:當模型越來越便宜,誰控制了企業真正稀缺的執行層?