NVIDIA AI 如何寫晶片?ACE-RTL 97.1% 真相

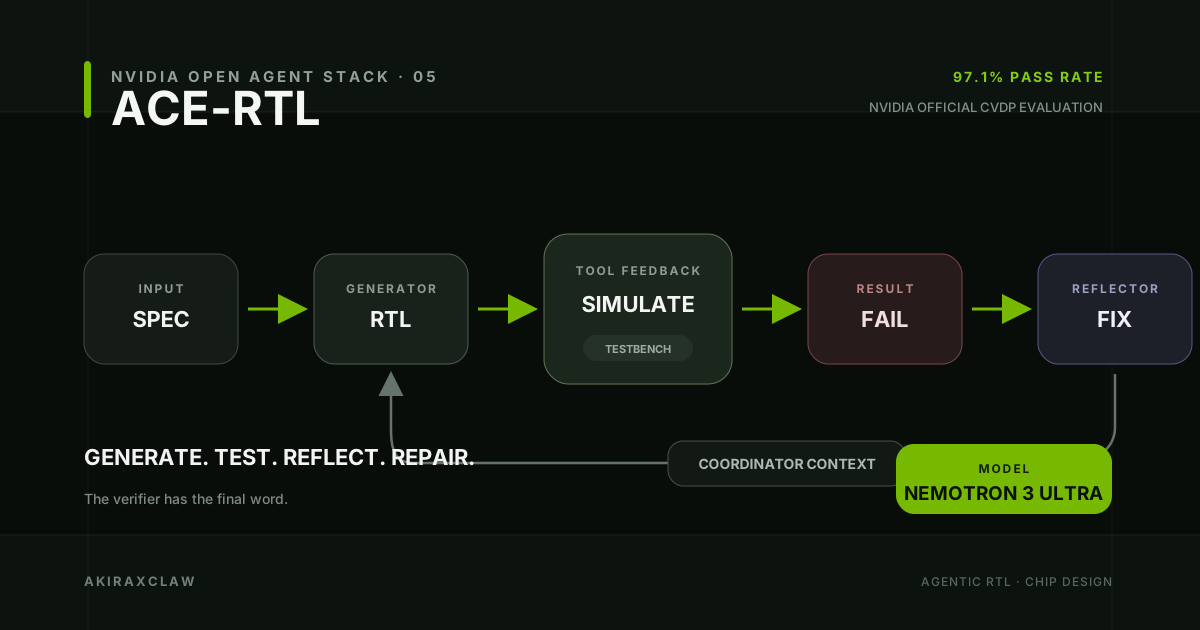
NVIDIA 以 Nemotron 3 Ultra 搭配 ACE-RTL,在九類 RTL 任務取得 97.1% 平均 pass rate。本文拆解 Agent 如何生成、模擬、反思與修正晶片邏輯,並說清楚 benchmark 通過與真正完成晶片量產之間的距離。
目錄+
NVIDIA 說,Nemotron 3 Ultra 在九類 agentic RTL 任務拿到 97.1% 平均 pass rate,每輪平均只使用 6,629 tokens。看到這個數字,很容易把它翻譯成「AI 已經能設計晶片」。
這個翻譯太快了。
97.1% 代表 Nemotron 3 Ultra 放進 ACE-RTL Agent 後,通過指定 CVDP test harness 的比例;它不是完整晶片的 tape-out 成功率,也沒有一次涵蓋 synthesis、timing closure、physical design 與 sign-off。真正值得注意的突破,是模型已不再只交出一段 Verilog,而能接受 simulator 的否決、讀取失敗,再回頭修改。
AI 晶片設計的第一個成熟形態,不是讓模型憑空畫出晶片,而是讓 Agent 接受驗證工具的否決。
RTL 是什麼?所謂「寫晶片」在寫什麼
RTL 是 Register-Transfer Level,中文常譯為暫存器傳輸層。工程師使用 Verilog 或 SystemVerilog 描述資料如何在 clock 驅動下穿過 register、multiplexer、arithmetic unit 與 state machine。
它看起來像程式碼,但和 Python、JavaScript 不同。一般程式多半描述處理器依序執行哪些指令;RTL 描述的是硬體電路本身,許多邏輯會同時運作。一次錯誤的 bit width、reset 條件或 non-blocking assignment,都可能讓晶片在特定 cycle 產生錯誤結果。
RTL 也只是晶片流程的前段。它往後還要經過邏輯綜合,轉成 gate-level netlist,再進行 placement、routing、timing、power、DRC、LVS 與最終 sign-off。把一段 RTL 跑過測試,和把晶片送進晶圓廠,中間還隔著很多道門。
為什麼一次生成 Verilog 不夠
軟體生成錯誤,常會直接拋出 exception;硬體錯誤可能通過編譯,卻在幾千個 clock cycles 後才以錯誤波形出現。
CVDP benchmark 論文整理了 783 個由硬體工程師撰寫的問題,橫跨 13 類 RTL design 與 verification 任務。論文早期測試的單輪模型,在 code-generation problems 上最高約 34% pass@1;testbench checker、assertion 與 verification 類別尤其困難。
這個 34% 不能直接和後來 ACE-RTL 的 97.1% 放在同一張排行榜。模型世代、提示、迭代次數和評測方式都不同。它真正說明的是:RTL 任務很難靠「讀規格,第一次就寫對」解決。實際工程本來就是反覆執行 compiler、simulator、lint、assertion 與 waveform inspection。
這正是 Agent 能介入的地方。
ACE-RTL:讓三個角色共同記住失敗
ACE-RTL 全名是 Agentic Context Evolution for RTL。它把工作拆成三個角色:
- Generator 產生或修改 RTL。
- Reflector 閱讀 simulator、testbench 或工具輸出,推測失敗根因並提出高階修正方向。
- Coordinator 管理逐輪累積的 context,保留真正有用的錯誤與嘗試,避免模型反覆踩回同一個坑。
這裡的關鍵不是把三個聊天機器人排成一列,而是 context 如何演化。Generator 需要看到目前設計;Reflector 要把冗長 log 濃縮成可行假設;Coordinator 再決定下一輪保留哪些 history。如果所有失敗訊息都無限塞回 prompt,context 會變長、衝突也會增加;如果清得太乾淨,Agent 又會忘記已證明無效的做法。
這也解釋了它和 NeMo Gym 訓練環境的共同觀念:模型不能自己宣布成功,環境與 verifier 才能決定任務是否通過。ACE-RTL 把 verifier 換成硬體 simulator、testbench 與 EDA tools。
一個簡化案例:reset 寫錯,語法仍然可以通過
假設規格要求一個兩位元 counter:rst_n 一旦拉低,counter 必須立即歸零,不必等下一個 clock edge。這代表 asynchronous reset。
Generator 第一版卻寫成:
always_ff @(posedge clk) begin
  if (!rst_n) count <= '0;
  else if (enable) count <= count + 1'b1;
end
這段 RTL 可以編譯,也可能通過只在 clock edge 切換 reset 的簡單測試。但當 testbench 在兩個 clock edges 之間拉低 rst_n,count 不會立即歸零,測試就會失敗。
Reflector 看到「reset asserted, expected 0, observed 3」和波形時間點後,可以推測問題不是加法器,而是 reset semantics。下一輪只需做局部修正:
- always_ff @(posedge clk) begin
+ always_ff @(posedge clk or negedge rst_n) begin
這是教學示意,不是 NVIDIA 公開 benchmark 的原始題目。它要表達的是 Agent 的價值來源:錯誤訊息把龐大的可能性縮小,模型不必每輪從零猜測。
97.1% 是怎麼測出來的
NVIDIA 2026 年 7 月 26 日發布的技術文章使用九類 CVDP code-generation tasks,涵蓋 RTL completion、自然語言規格轉 RTL、修改、module reuse、lint 與 QoR improvement、testbench stimulus、checker、assertion 和 debugging。
三個模型都放進相同 ACE-RTL pipeline,並讓同一個受測模型擔任 Agent loop 裡的 LLM。官方公布的平均結果如下:
| ACE-RTL 使用的模型 | 九類平均 pass rate | 每輪平均 tokens |
|---|---|---|
| Nemotron 3 Ultra | 97.1% | 6,629 |
| Kimi K2.6 | 95.2% | 22,579 |
| GLM 5.2 | 92.1% | 9,156 |
這張表能支持兩個有限結論:在 NVIDIA 的設定中,Nemotron 3 Ultra 通過的題目較多,而且每輪 token usage 較少。它不能直接證明整體運行成本最低,因為總成本還取決於迭代次數、並行 attempts、模型服務價格、simulator 時間與商業 EDA license。
數據來源和 benchmark 作者也與 NVIDIA 研究團隊高度相關。因此本文把它稱為「NVIDIA 官方評測」,不寫成獨立第三方驗證。
真正重要的對照:模型單打與 Agent 迴圈
NVIDIA 另外公布 CVDP cid016 debugging 類別的對照:Nemotron 3 Ultra 單獨回答時為 65.7%,進入 ACE-RTL 後達到 100%;Kimi K2.6 從 68.6% 變成 97.1%,GLM 5.2 則從 44.0% 變成 94.3%。
每個模型都因 Agent loop 受益,這表示 97.1% 不能全部記在 Nemotron 3 Ultra 帳上。模型提供 RTL knowledge、長 context 與 reasoning;ACE-RTL 提供工具、狀態、重試策略與錯誤回饋。少了其中一邊,成績都會變。
這和 NeMo RL 的 Agent 強化學習流程也有一條連線。可靠 reward 或 verifier 不只用來訓練模型,也能在 inference time 引導 Agent。差異在於 ACE-RTL 此處主要是多輪推論與工具迴圈,不要把每一次 simulator feedback 都誤稱為 online reinforcement learning。
Nemotron 如何學會修 RTL,而不只是背 Verilog
ACE-RTL 論文描述的 RTL-specialized model,使用約 170 萬筆 RTL samples。NVIDIA 後續文章則說明,Nemotron 3 Ultra 的 RTL 能力受益於類似 synthetic data generation pipeline。
資料不是只有「規格對應正確程式碼」。流程從公開 repository 篩出 RTL seed designs,再用 open LLM 生成 instruction-style samples,包括三種重要任務:
- 從自然語言 specification 生成 RTL。
- 對既有 RTL 做功能修改與 code improvement。
- 注入 FSM transition、handshake、timing 等錯誤,再建立 debugging 與 repair samples。
生成資料還要經過 syntax check、benchmark decontamination,以及 LLM-as-judge 的 rubric-based scoring,檢查 specification 與 RTL 是否語意一致。原始 X 貼文附圖呈現的正是這條 synthetic data pipeline,而不是 ACE-RTL 的 runtime loop。
需要保留一個界線:論文中的 170 萬筆資料、RTL-specialized model,與 NVIDIA 後來用 Nemotron 3 Ultra 擔任整個 ACE-RTL loop 的評測,不是完全相同的實驗。可以說方法延續,不能把所有數字拼成同一場訓練。
這種「先合成錯誤,再訓練修復」的思路也回應上一篇 Nemotron 3 開放模型策略:NVIDIA 公開的不只是 weights,而是資料、recipes、Agent 與部署路徑。模型能力開始和生成資料、verifier 及 runtime 一起出售價值。
從 benchmark pass 到 tape-out,還差五道門
第一道是 test coverage。Agent 通過 harness,只代表所有已執行測試都通過。testbench 沒想到的 corner case,模型和人類都可能一起漏掉。
第二道是 formal verification。Simulation 只能檢查跑過的輸入與時間路徑;formal tools 嘗試證明特定 property 在整個狀態空間成立。對 protocol、safety property 與控制邏輯,兩者不能互相取代。
第三道是 synthesis 與 PPA。功能正確的 RTL 仍可能面積太大、速度太慢、功耗過高,或在綜合後產生意外結構。CVDP 有 lint 與部分 QoR tasks,但不等於完整產品限制已收斂。
第四道是 physical design 與 sign-off。Placement、routing、clock tree、timing closure、power integrity、DRC、LVS 都不是這個 97.1% 指標測量的內容。
第五道是 工程治理。商業晶片包含未公開 IP、製程資料與客戶規格。團隊必須知道 code、logs 和 waveforms 送到哪個模型端點,誰核准修改,出錯時如何追蹤,以及哪個版本真正進入 sign-off。
所以最準確的描述是:ACE-RTL 已展示強大的 RTL coding 與 verification assistant,不是已公開證明的 autonomous chip company。
它會取代 EDA 工具,還是成為 EDA 的新操作層?
NVIDIA 的文章列出 Cadence ChipStack AI Super Agent、Siemens Questa One Agentic Toolkit 與 Fuse EDA AI Agent,以及 Synopsys AgentEngineer 等整合。這個合作名單透露一件事:Nemotron 不打算自己重做 simulator、formal solver、place-and-route 與 sign-off engine。
比較可能的產業結構是,LLM Agent 成為 EDA 工具之上的協調層。它閱讀規格、選擇工具、解讀輸出、修改 RTL,再把可追蹤的結果交回既有 sign-off 流程。EDA 廠商仍控制確定性引擎、製程支援與企業工作流;NVIDIA 則提供模型、Agent framework 與算力。
對工程師而言,最先被壓縮的會是重複性工作:樣板 RTL、局部修改、log triage、testbench 草稿與 regression orchestration。規格是否完整、架構如何取捨、coverage 是否足夠、formal property 是否正確,以及風險是否能被簽核,仍需要人負責。
工作不會只剩按下「生成」。反而會更像管理一群速度很快、但不能自己簽名的工程協作者。
團隊現在怎麼開始,風險最低
NVlabs/ACE-RTL repository已公開 Agent skills、角色元件、CVDP integration scripts 與外部模型 adapter。常見的開源工具包括 Icarus Verilog、Verilator 與 Yosys;某些 CVDP rows 仍需要自行取得 Cadence 等商業工具。
合理起點不是把尚未發布的 IP 丟進雲端,而是挑一個沒有機密的小型 module:先用單一 attempt、單一 iteration 跑通環境,保存 specification、tool versions、prompt、diff、logs 與測試結果,再逐步增加重試和並行度。任何送往正式 branch 的修改,都應保留人工 approval gate。
如果要在本地測開源 simulator、小模型或量化 RTL assistant,RTX PRO 4000 Blackwell 24GB 可作為工作站規格參考;它無法單卡運行 550B-A55B 的 Nemotron 3 Ultra,也不代表能取代商業 EDA 環境。先確認模型大小、runtime 與工具授權,再決定買硬體或使用 API。
聯盟揭露:上方連結為蝦皮聯盟連結,若透過連結購買,我可能取得少量分潤,不影響你的價格與本文判斷。
常見問題
RTL 與一般程式碼有什麼不同?
一般程式描述處理器要執行的指令;RTL 描述 register 之間的資料如何隨 clock 移動,以及硬體邏輯如何並行連接。RTL 最後會被合成成邏輯閘,所以 cycle、width、reset 與 timing 都是功能的一部分。
97.1% 是否代表 AI 能自動設計完整晶片?
不是。它是 ACE-RTL 搭配 Nemotron 3 Ultra 在九類 CVDP RTL tasks 中的官方平均 pass rate。它沒有證明完整 formal、synthesis、timing closure、physical design、sign-off 或 tape-out 都能自動完成。
ACE-RTL 是開源專案嗎?
是。NVlabs 已公開 repository,包含 Agent skills、角色元件、benchmark integration 與模型 adapter。部分評測需要的商業 EDA tools 和 license 不會因 Agent 開源而自動取得。
為什麼 Agent 比單獨使用模型準確?
因為 simulator 與 testbench 提供確定性的失敗訊號,Reflector 能縮小根因範圍,Coordinator 則保存有效除錯脈絡。模型可以根據新證據修正,而不是只靠第一次生成。
RTL 工程師會被 AI Agent 取代嗎?
目前證據比較支持工作重新分配。生成、log 分析和局部 repair 會先自動化;規格、架構、coverage、formal、資安、責任判斷與最終 sign-off 仍需要工程師。
結論:模型開始寫晶片,驗證工具仍握有否決權
Nemotron 3 Ultra 的 97.1% 很亮眼,但最重要的主角不只是一個 550B 模型。ACE-RTL 把 Generator、Reflector、Coordinator 與 simulator 接成閉環,讓模型能從失敗中繼續工作。
這套方法把 AI 從 RTL autocomplete 推向可追蹤的工程迭代,也把問題從「模型會不會寫 Verilog」改成「團隊能不能提供可信的 verifier、完整的規格與安全的執行環境」。
晶片不接受差不多正確。Agent 真正進入半導體工程的門票,不是更會說服人,而是更願意被工具證明它錯了。