NVIDIA Rubin 量產了,你卻買不到一張卡

NVIDIA Rubin 在 GTC Taipei 進入全面量產,出貨卻要到秋天,最小單位還是五櫃 POD 不是顯卡。這篇拆七顆晶片、NVL72 內部,以及它跟 Blackwell 差在哪。
目錄+
2026 年 5 月 31 日,NVIDIA 在台北說 Vera Rubin 進入全面量產。同一份新聞稿最後才講:出貨要到秋天。
工廠開始轉了。你還是買不到一張卡。
因為 Rubin 賣的不是卡。它賣的是一整座機房。
同一場演講怎麼講 AI 堆疊,之前寫過這篇。下面只拆產品線。
Rubin 到底是什麼
Vera Rubin 是五種專用機櫃編成的一台電腦。 NVIDIA 自己的定位是:給會自己拆任務、呼叫工具的 AI 用的工廠。
不是 PCIe 卡。也塞不進你桌上的機箱。
圖:NVIDIA 新聞稿〈Vera Rubin Ramps Into Full Production〉(1920×1080)。
為什麼要拆成五櫃
現在的 AI 不是問一句回一句。它會規劃、呼叫工具、跑程式、再檢查結果。這四件事吃的資源不一樣。
- 算力:長推理、MoE 路由,要 GPU
- 沙箱:編譯、跑測試、驗證,要 CPU
- 記憶:每多走一步,KV cache 就變大,要專門的儲存
- 同步:上面三層要編成一台機器,要網路
一張再大的卡,解不了四種瓶頸。所以 NVIDIA 做了五櫃。
後面出現的倍數,全部是 NVIDIA 自己講的,不是獨立實測。機器還沒大量出貨,第三方評測也還沒開始。先講清楚,後面不再每段複誦一次。
五櫃各自在幹嘛
NVL72:真正在算的那櫃
72 顆 Rubin GPU,36 顆 Vera CPU,用第六代 NVLink 連成「一顆大 GPU」。這是主引擎。
技術部落格寫得更土:18 個運算托盤、9 個交換托盤、大約 130 萬個零件。整櫃大約 4,000 磅,接近一台皮卡車。
背後那排銅線有四組預組匣、大約 5,000 條、總長超過兩英里。單櫃互連頻寬寫 260 TB/s。
組裝從近兩小時砍到五分鐘。這不是跑分,是 NVIDIA 在為「一年換一代機櫃」降低維修成本。
比較小的還有 DGX Rubin NVL8、HGX Rubin NVL8、Vera Rubin NVL4。再往上的 Ultra NVL576、Kyber NVL1152 是路線圖,現在量產的不是那些。
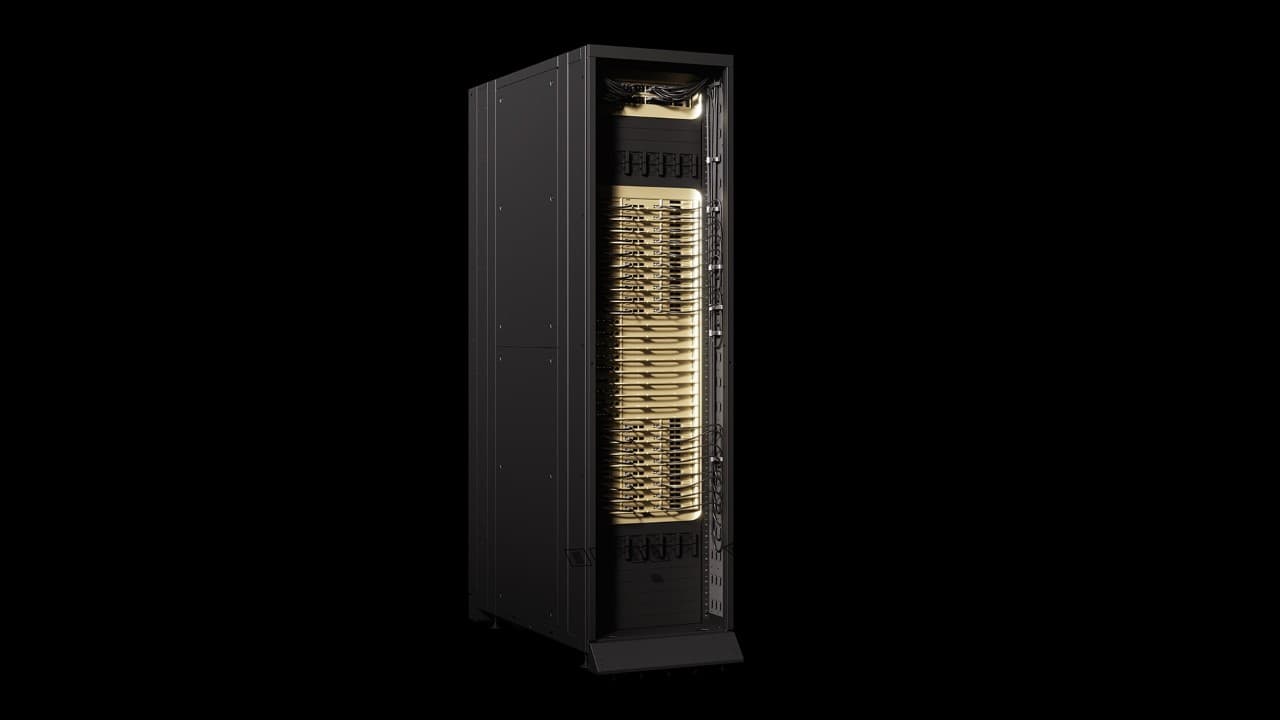
圖:NVIDIA 官方產品頁的 NVL72。
Rubin GPU:再強也不單獨賣
架構文寫:3360 億顆電晶體、224 個 SM、288 GB HBM4、記憶體頻寬 22 TB/s。官方說頻寬是 Blackwell 的 2.8 倍。
它要解的是三條慢路徑:
- MoE 要把專家權重搬來搬去
- 長上下文的 attention 會卡在 softmax
- 一個字一個字吐的時候,吃的是記憶體頻寬,不是再多幾個 TFLOPS
所以這顆 GPU 再強,也不會做成你能插上主機板的卡。
Vera CPU:88 核不是給人用的
新聞稿標題就寫:the CPU for Agents。88 顆 Olympus 核心,記憶體頻寬最高 1.2 TB/s,官方說任務完成速度比 x86 快 1.8 倍。
一櫃最多 256 顆。官方寫可同時撐超過 22,500 個沙箱,讓 AI 去編譯、跑測試、驗證結果。
GPU 算出東西之後,要有地方跑這些雜事。不然加速卡就在空轉等 CPU。
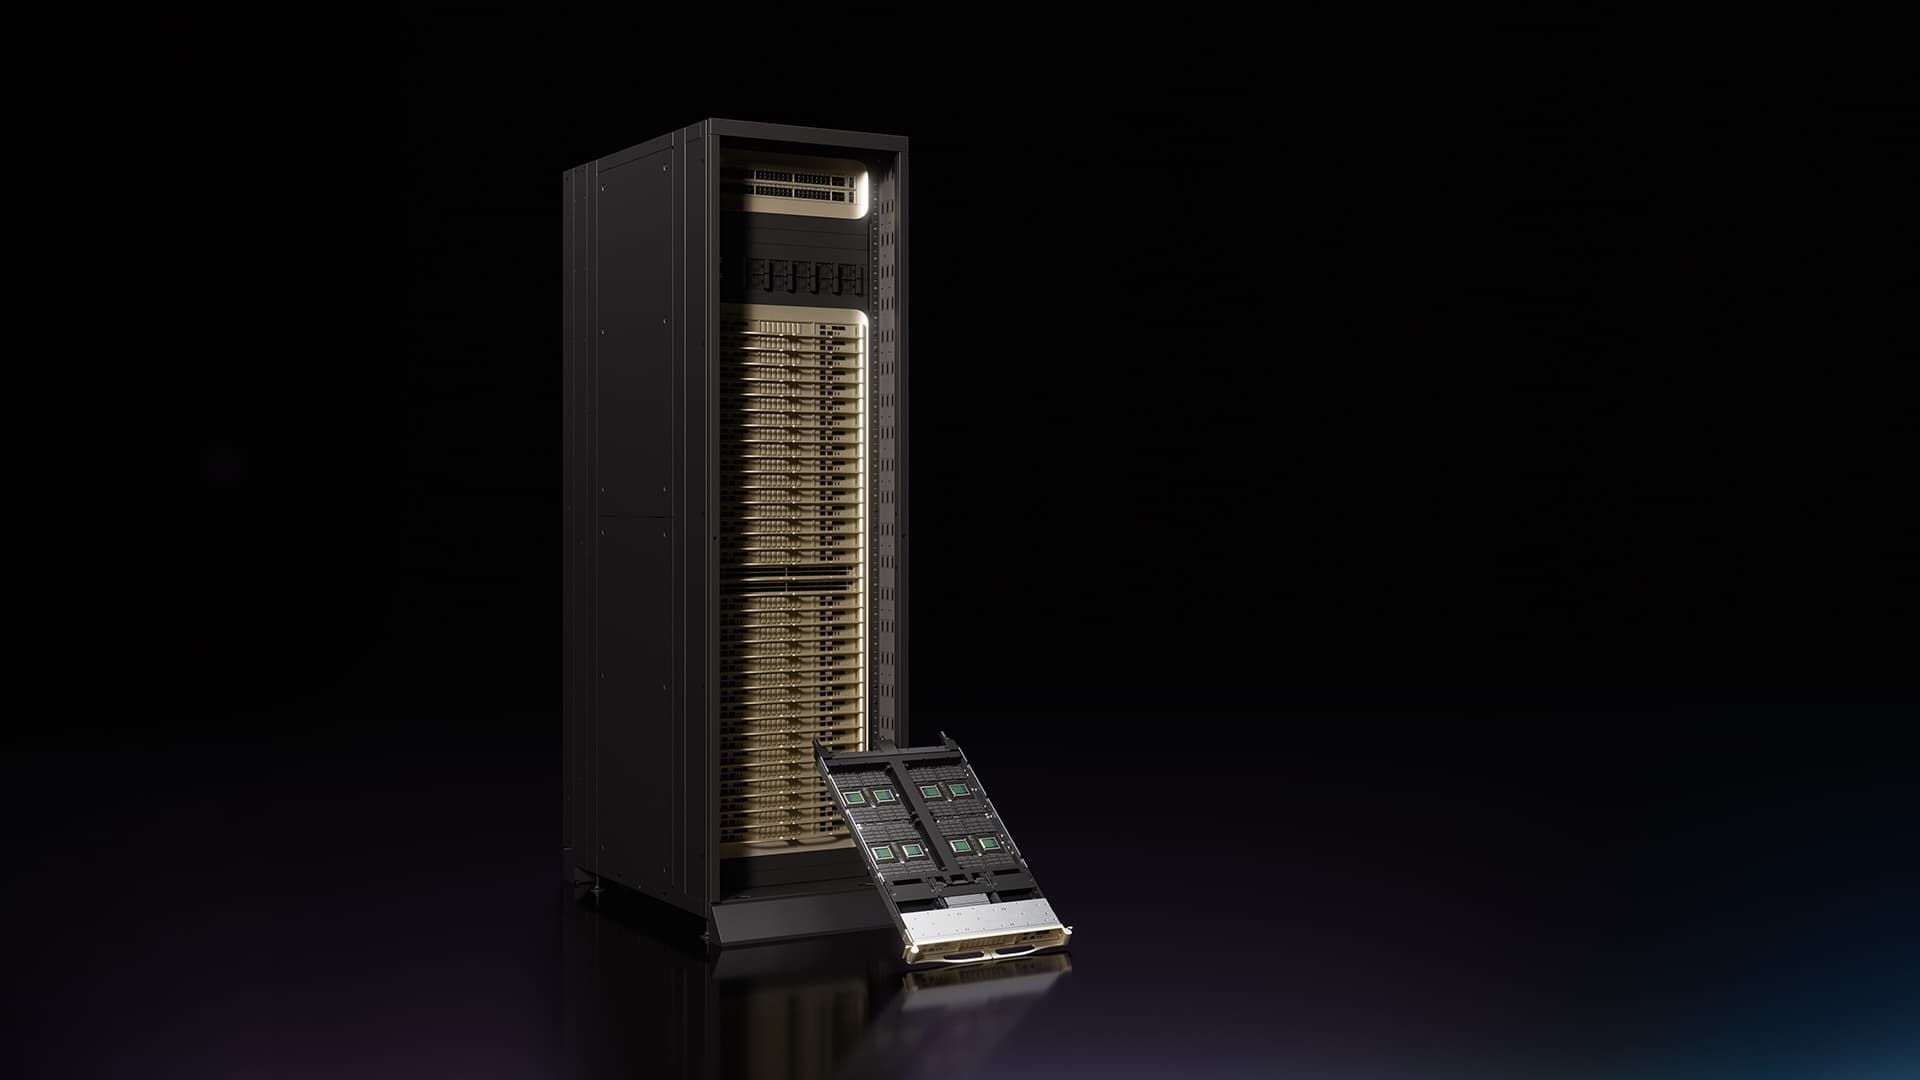
圖:NVIDIA 新聞稿〈Unveils Vera, the CPU for Agents〉。
LPX:要快的那櫃
NVL72 用 HBM 扛容量。LPX 用 SRAM 扛速度。官方寫一櫃 256 顆 LPU,整櫃 128 GB SRAM。
HBM 搬得動很大的暫存。SRAM 容量小,但來回極快。NVIDIA 把 Groq 的晶片編成同一套機櫃模具出貨,是怕客戶自己硬接兩套互不相通的叢集。
值不值得加買,要等雲端把「只有 NVL72」和「NVL72 加 LPX」分開標價才知道。
STX 和 SPX:記憶跟配線
STX 管 KV cache。講人話:AI 每多想一步,就要多記一截對話。這截若只能待在單卡記憶體裡,一長就要卸載,速度立刻掉下來。NVIDIA 把它做成獨立機櫃,等於承認「記憶」已經從卡上長到機房裡。
SPX 是光交換那櫃。它的工作就一件事:把上面四櫃編成一台電腦。
裡面其實有七顆晶片
五櫃是外殼。裡面要一起出貨的是這七顆:
- Rubin GPU:主算力
- Vera CPU:沙箱跟調度
- NVLink 6 Switch:櫃內互連
- ConnectX-9 SuperNIC:櫃外網路
- BlueField-4 DPU:儲存跟隔離
- Spectrum-X 共封裝光學:用光,不用一堆可插拔模組
- Groq 3 LPU:低延遲加速
CES 前後 NVIDIA 寫過「六顆新晶片」。後來把 Groq 加進來,變成七顆。讀規格以產品頁和 3 月那篇 POD 技術稿為準。
跟 Blackwell 差在哪
你現在租得到的是 GB200、GB300。Rubin 是下一櫃。
CPU
現役:Grace
Rubin:Vera,88 核
GPU 記憶體
現役:HBM3E
Rubin:HBM4,單顆 288 GB
櫃內互連
現役:上一代 NVLink
Rubin:NVLink 6,單 GPU 3.6 TB/s
出貨
現役:現在就有
Rubin:工廠在轉,秋天開始出
產品頁還寫:同樣訓練一個 MoE,GPU 大約只要四分之一;每百萬 token 成本大約十分之一。對照用的是指定模型和指定長度。換模型,數字就會動。
時間線很單純。2024 出 GB200,2025 出 GB300,2026 量產 Rubin。一年一櫃,已經不是顯示卡的節奏。
量產的意思是:台灣跟全球系統廠開始用同一套模具大量組櫃。你租得到,還要再等燒機、認證、上架。中間這幾個月,市場上會同時存在三種東西:還在賣的 GB300、已經量產但還沒上雲的 Rubin、投影片上的 Ultra。
軟體沒換代。換機櫃也離不開 CUDA,這件事寫在 CUDA-X 那篇。
機櫃才是護城河
Rubin 難抄的不一定是 GPU。是第三代 MGX 機櫃:沒有線、沒有軟管、沒有風扇,45°C 溫水就能冷。
電力也重做了。AI 一跑,電網會抖。官方說同一座電廠最多能多塞 30% GPU,配上 DSX 甚至寫到 40%。前提是整座機房願意改供電和冷卻,不是換幾張卡。
Dell、HPE、Lenovo、Supermicro,再加上華碩、鴻海、廣達、緯創,都在名單上。這代表代工線從樣品轉成出貨。還沒發生的,是雲端價目表。
你現在用得上嗎
桌上買不到。最小單位是液冷機櫃。桌上能買的上一世代是 Spark 跟 Station,走的還是 Blackwell。
雲端也還租不到 Rubin 實例。秋天出貨之後,你最先碰到的會是雲端機櫃,不是宅配箱。
多數人現在不該為 Rubin 採購。它解決的是機房帳單,不是本機 70B。現役能自己裝的,仍是 Blackwell 工作站卡,例如 麗臺 RTX PRO 5000 Blackwell。
利益揭露:本文部分連結為聯盟連結,你透過連結購買不影響價格,我會獲得小額分潤。
單卡跑得動,Rubin 跟你無關。已經在為長任務付雲端帳單,去問雲端商:NVL72 何時上架,計價是算 GPU 小時還是算 token。
那張價目表如果沒比 GB300 便宜一個數量級,前面那些倍數就只是投影片。
常見問題
NVIDIA Rubin 是什麼? Vera Rubin 是 NVIDIA 下一世代的機櫃平台,不是一張顯示卡。五種專用機櫃編成一個 POD,給會自己拆任務、呼叫工具的 AI 用。
Vera Rubin 現在買得到嗎? 買不到單卡,也還沒大量出貨。2026 年 5 月 31 日官方說進入全面量產,出貨從當年秋天開始。
Rubin 跟 Blackwell 差在哪? Blackwell 是上一世代機櫃。Rubin 換成 Vera CPU、HBM4、NVLink 6。官方說 agent 吞吐量大約 10 倍、每百萬 token 成本大約十分之一。這些是官方預估,頁面上標了會改。
RTX Spark、Nemotron 算 Rubin 系列嗎? 不算。Spark 是桌上的 AI 電腦,Nemotron 是開源模型。同一場台北演講一起講,但不是同一條產品線。
一般開發者現在該做什麼? 桌上繼續用現役 Blackwell。Rubin 最小單位是液冷機櫃。你該盯的是雲端哪一天把 NVL72 掛上價目表。