RAG 不用 vector DB 了?PageIndex 打出 98.7% FinanceBench 的技術路線

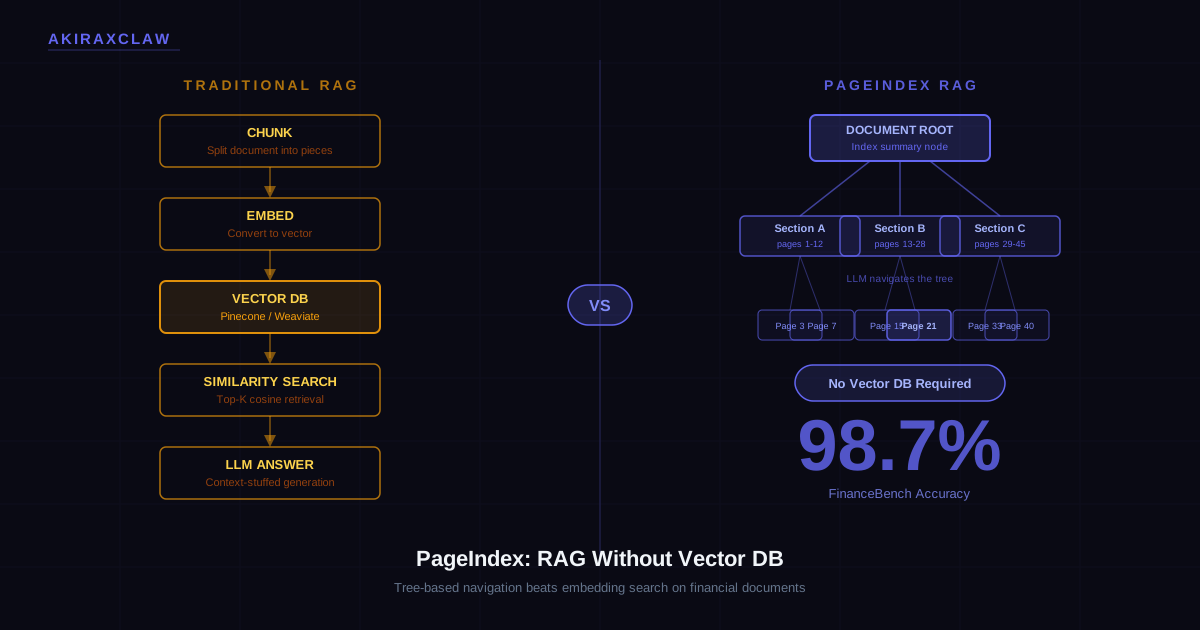
VectifyAI 的 PageIndex 拋棄了 vector DB、embedding 和 chunking,改用樹狀索引讓 LLM 像人一樣導航文件,在 FinanceBench 拿到 98.7%——傳統 vector RAG 約 30-50%。但它也不是萬能的替代品。
目錄+
「最好的 RAG 可能沒有 vector DB。」三年前這句話說出來,大概會被當成玩笑。整個 RAG 社群的預設答案是:切 chunk、生 embedding、丟進 Pinecone、做 similarity search,這就是完整流程。但 VectifyAI 的 PageIndex 正在挑戰這個預設——而且它帶著一個很難忽視的成績單回來。
Similarity search 的根本假設
傳統 vector RAG 依賴一個隱含前提:語意上相似的片段,就是回答問題需要的片段。這在問「Python 怎麼排序 list」這類問題時大致成立。但在財報分析、法律合約、技術手冊這類場景,問題的答案往往藏在文件結構深處——一個數字要對照三個地方的定義才能正確解讀,而這三個地方在 embedding 空間裡未必彼此接近。
Similarity 不等於 relevance。PageIndex 的核心主張就是從這裡出發的。
PageIndex 怎麼運作
PageIndex 不切 chunk,不生 embedding,也不維護 vector DB。它做的事情是:對文件建立一個分層樹狀索引(hierarchical tree index),然後讓 LLM 像人讀書一樣,從目錄層級開始,逐步導航到需要的節點,取出精確的段落作為 context。
這個架構有一個自我修正機制:如果目錄(TOC)抽取的準確率低於 60%,系統會自動 cascade 三個 fallback 模式,確保索引結構的可靠性。
整個過程沒有 embedding 模型、沒有向量運算、沒有 similarity threshold 需要調校。
FinanceBench:98.7% vs 30–50%
FinanceBench 是針對財報分析設計的 RAG 基準測試,問題需要精確對照 SEC 財報文件中的數字和定義。這類文件有幾個特性:高度結構化、數字密集、上下文依賴強——正好是傳統 similarity search 最容易出錯的場景。
PageIndex 在 FinanceBench 拿到 98.7% 準確率,傳統 vector RAG 的成績大約落在 30–50% 之間(不同基準來源的估計有些差異,buildfastwithai.com 的數據是 30–50%,ruh.ai 的統計則在 50–65%)。
「Similarity search 在結構化長文件面前,找到的是相似的片段,不是正確的答案。」
這個差距不是小幅改進,而是結構性的。問題本身的性質讓 vector RAG 在這個場景天生處於劣勢。
它不是 Pinecone 的替代品
誠實地說:PageIndex 有明確的侷限,而且這些侷限不容忽視。
高延遲、高成本。 讓 LLM 在文件樹裡推理導航,每次查詢消耗的 token 數量遠高於傳統 similarity search。這不是工程優化就能完全解決的問題,而是架構本質的代價。
Scalability 限制。 sjramblings.io 明確指出,PageIndex 在大量文件的場景下 scalability 較差。如果你需要跨幾十萬份文件做快速搜尋,這個架構不適合。
適用場景很具體: SEC 財報、法律合約、技術手冊——這類有清晰結構的長文件。不適合:大規模、快速、跨文件的通用搜尋。
Sponsored · 蝦皮 · 工作站顯卡
Sponsored · 蝦皮 · 工作站顯卡
麗臺 RTX PRO 4000 Blackwell · 24GB 本地跑 32B 級模型 4-bit 量化
NVIDIA Blackwell 架構工作站繪圖卡,24GB VRAM 放得下 Qwen2.5 32B 的 4-bit 量化版(約 20GB);70B 的 4-bit 量化版約 42GB,需要更大的卡。也適合 3D 設計與影像算圖。
什麼時候應該認真評估 PageIndex
如果你的 RAG 應用符合以下任一條件,PageIndex 值得放進技術選型清單:
- 文件本身有清晰的結構(目錄、章節、條款編號)
- 問題需要跨段落的精確對照,而不是「找相似內容」
- 準確率優先於查詢速度和成本(金融、法律、合規場景)
- 文件數量在合理範圍內,不需要跨幾十萬份文件的大規模搜尋
如果你的需求是「快速搜尋大量非結構化文件」,傳統 vector RAG 或 hybrid search 仍然是更務實的選擇。
結語
PageIndex 的意義不在於「取代 vector DB」,而在於它清楚地示範了similarity search 作為 RAG 唯一假設是有問題的。對於財報分析、法律審閱、技術文件這類場景,98.7% vs 30–50% 的差距已經足夠說服工程師重新思考架構選型。
對那些領域,PageIndex 是升級。對快速大規模通用搜尋,它不是答案。這個邊界本身,比任何一個跑分數字都更值得記住。
利益揭露:本文部分連結為聯盟連結,點擊購買我會獲得回饋,不影響你的價格。