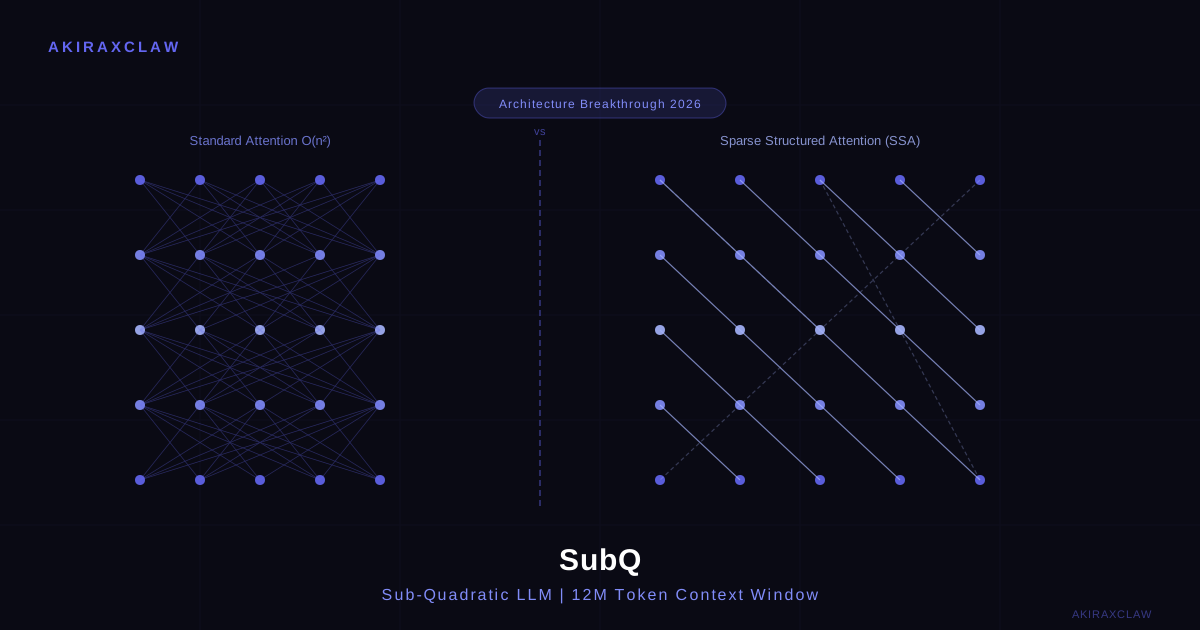

Transformer 每次都計算所有 token 的相互關係,SubQ 的 SSA 架構只處理真正重要的那些——結果是 12M token context 和 52x 的速度提升,而不是 52x 的成本。
目錄+
標準 Transformer 在 1M token 情境下要計算一兆次 token 對的注意力分數,SubQ 只計算其中約 1/62.5。這不只是 context window 擴展的工程問題,它動到了 LLM 最核心的計算假設。這篇文章拆解 SubQ 的 SSA 架構、已驗證的 benchmark 數字,以及它對台灣開發者實際意味著什麼。
標準注意力的根本問題
Transformer 的注意力機制天生是 O(n²) 的。兩個 token 之間的關係需要計算一次,n 個 token 就有 n² 個 pair。這在短序列下不是問題,但 context window 一拉長,計算量就爆炸性成長。
1M token,就是 10¹² 次計算。
FlashAttention 優化了記憶體存取的方式,讓同樣的 O(n²) 計算在 GPU 上跑得更快——但計算量本身沒有減少。這就是為什麼 FlashAttention 在 1M token 下仍然很貴。
SubQ 改的不是怎麼算,而是算什麼。
SSA 架構的核心邏輯
SubQ 的架構稱為 SSA(Subquadratic Selective Attention)。它的核心主張很直白:在任何給定的 context 裡,絕大多數 token pair 的注意力權重接近零,根本不影響輸出。標準 Transformer 計算了那些零,SSA 不計算它們。
以下是兩種架構在處理長上下文時的路徑差異:
flowchart TD
    A[輸入序列 n tokens] --> B{注意力策略}

    B --> C[標準注意力<br/>Dense Attention]
    B --> D[SSA<br/>SubQ 稀疏注意力]

    C --> E[計算所有 token pair<br/>n x n 矩陣]
    E --> F[O n 平方 複雜度]
    F --> G[1M token 需要<br/>龐大 FLOPs]

    D --> H[內容感知選擇<br/>Content-Dependent Selection]
    H --> I[只保留重要的 pair<br/>稀疏子集]
    I --> J[亞線性縮放<br/>Sub-quadratic Scaling]
    J --> K[1M token<br/>62.5x 更少 FLOPs]

    G --> L[輸出]
    K --> L
關鍵在「content-dependent selection」這一步。SSA 不是靜態地丟掉固定位置的 token——它根據輸入本身動態決定哪些關係值得計算。這讓它在保持模型表達力的同時,大幅削減計算量。
已驗證的數字
SubQ 公開的技術數字,來自 subq.ai 官方、The New Stack、explainx.ai 的 2026 年 5 月報導:
| 項目 | SubQ 數字 |
|---|---|
| 注意力 FLOPs 削減 | 62.5× vs 標準 quadratic attention at 1M tokens |
| 速度 vs FlashAttention | 52.2× faster at 1M tokens(B200 GPU) |
| Context window(研究) | 12M tokens |
| 現有公開版本 | 1M-Preview |
| Needle-in-Haystack(1M context) | 95%(Claude Opus 4.6 是 94.8%) |
| MRCR v2 score | 83(比 OpenAI 高 9 分) |
Needle-in-Haystack 是長上下文能力的標準測試:在 1M 個 token 的文本裡藏一個事實,然後問模型找得到嗎。SubQ 1M-Preview 的 95% 略高於 Claude Opus 4.6 的 94.8%,這個數字值得注意——不是因為差距大,而是因為這是用次二次方計算複雜度跑出來的結果。
MRCR(Multi-Round Consistency and Reasoning)是測試長 context 下多輪推理一致性的 benchmark,83 分比 OpenAI 高出 9 分是比較大的差距。
12M token 的實際意義
目前公開的 1M-Preview 已經是大部分閉源模型的頂端。12M token 的研究結果還沒有商業化,但它說明了 SSA 的 scaling 路線是可行的——不需要每次擴展 context 就等比例增加計算成本。
12M token 大約等於:
- 一個完整的大型 codebase(10 萬行以上)
- 整本《Harry Potter》系列加上大量參考文件
- 幾個月的對話記錄 + 相關文件
這不是說你下個月就會用到 12M token。這是說 SSA 架構打開了一個以前算不起來的空間。
SubQ Code:對開發者的直接影響
SubQ 有一個叫 SubQ Code 的產品定位,設計為 Claude Code、Codex、Cursor 的 drop-in 層——意思是它可以插進現有的開發工具鏈,而不是要取代整套工作流程。
對台灣開發者來說,這個方向比單純「更大的 context window」更有意義。如果 SubQ Code 真的能作為 coding assistant 的後端層,那麼成本(宣稱低於 Opus 5% 的計算成本)才是決定它能不能普及的關鍵——而不是 benchmark 數字。
公司目前有 11 名 PhD researchers,架構論文預計公開,Hacker News 的討論是 skepticism 和 excitement 並存的正常反應:理論合理,但實際產品路線還需要時間驗證。
一個還沒有答案的問題
SSA 是「content-dependent selection」,這表示模型必須先評估哪些 token pair 重要,才能決定跳過哪些。這個選擇本身有成本。在實際部署中,這個 overhead 在什麼規模下開始被 FLOPs 節省抵消?這是目前技術文件沒有直接回答的部分。
稀疏注意力不是新想法,SubQ 的主張是它找到了一種 sparse selection 夠準確、overhead 夠低的組合——讓亞線性 scaling 真的能拿出可以對比 frontier model 的 benchmark。
如果 SSA 在量化評估上的選擇品質能撐住,那它代表的不只是「更長的 context 更便宜」,而是 LLM scaling 的一條新路線:不靠算力暴力堆疊,而是靠選擇性計算。這個路線對資源有限的研究者和開發團隊的意義,遠比對大廠更大。
問題是:便宜和準確能同時為真嗎?未來幾個月的獨立評測會給出答案。
如果你有興趣本地跑長 context 推論或做 LLM 實驗,目前台灣買得到的 VRAM 選擇:麗臺 RTX PRO 4000 Blackwell 24G 是跑量化版本的入門,麗臺 RTX PRO 5000 Blackwell 48G 是跑全精度 70B 的現實選擇。
利益揭露:本文部分連結為聯盟連結,點擊購買我會獲得回饋,不影響你的價格。