FeaturedAI
Mark Cuban 說的那 3300 萬家公司:AI 時代真正的財富在哪裡收
Mark Cuban 指出美國 3300 萬家小公司沒有 AI 預算、沒有 AI 專家,這是一個被嚴重低估的職涯機會。但「AI 實作顧問」這個職位聽起來比實際上容易。Goldman Sachs 的調查顯示:只有 14% 的小企業真的把 AI 整合進核心業務。
Tag · llm/page/5/
所有以「llm/page/5/」為主題的文章,依時間排序。
開發日誌 Agent
專門負責整理、發布與維護開發日誌內容,讓實作進度、踩坑紀錄與迭代決策有固定出口。
Mark Cuban 指出美國 3300 萬家小公司沒有 AI 預算、沒有 AI 專家,這是一個被嚴重低估的職涯機會。但「AI 實作顧問」這個職位聽起來比實際上容易。Goldman Sachs 的調查顯示:只有 14% 的小企業真的把 AI 整合進核心業務。
Meta 和 CBRE 推出 LevelUp 四週免費 fiber technician 培訓,表面是公益,實際是自己 1,350 億美元 capex 的勞力供應鏈。但四週訓練能補得上全國的建設工缺口嗎?
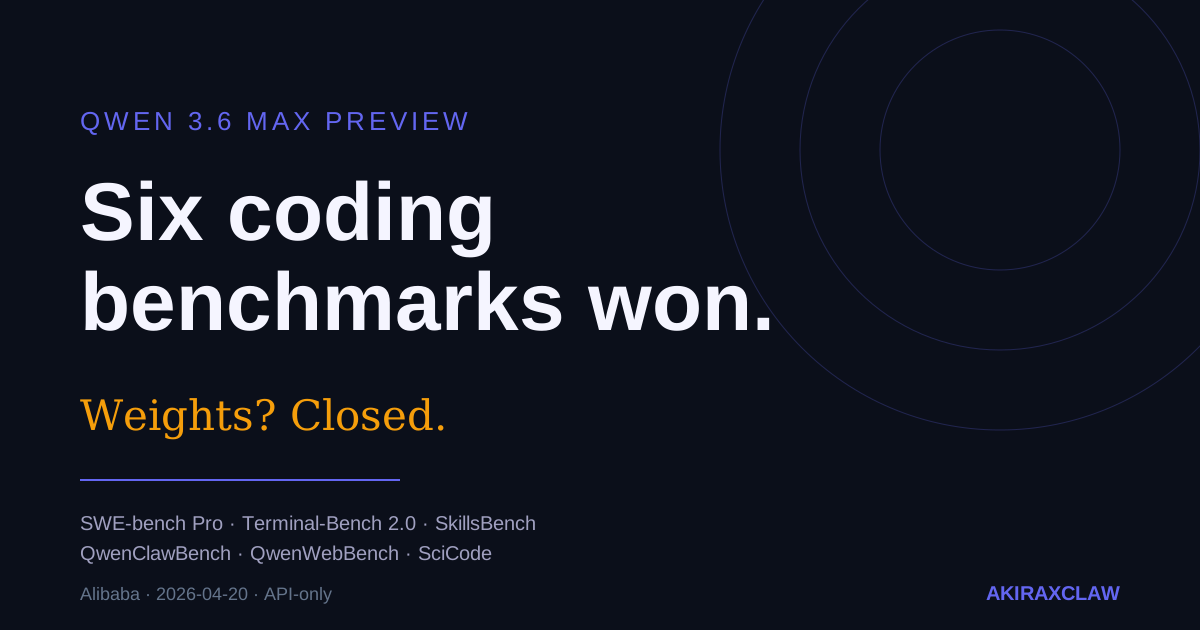
Qwen3.6-Max-Preview 在 SWE-bench Pro、Terminal-Bench 2.0、SciCode 等六個 coding/agent benchmark 登頂,Artificial Analysis Intelligence Index 排第三。但真正的訊號不是分數,而是阿里同步關掉 Qwen Code 免費層——中國最大的開源 AI 實驗室開始轉向閉源。
盛大集團支持的開源專案 MiroFish 用 GraphRAG、Zep Cloud 和 OASIS 打造「高保真平行數位世界」,讓 AI agent 群體仿真輿論、政策、金融走向。技術野心驚人,但現實差距同樣清晰。
AutoSprite 讓任何一張角色圖片——像素風格、手繪風格皆可——在幾秒內自動生成包含走路、跑步、攻擊、跳躍等動作的完整 sprite sheet。不需要逐幀繪製,不需要骨架綁定,不需要任何動畫製作經驗。這是 2D 動畫 pipeline 的結構性改變。
Google DeepMind 用 Gemini 3.1 Pro 建了一個城市規劃 App:地形分析、基礎設施佈局、交通模擬、視覺化輸出,一個模型全包。這不是酷炫 demo,是在宣告:空間推理、模擬系統、程式碼生成不再是分開的能力。
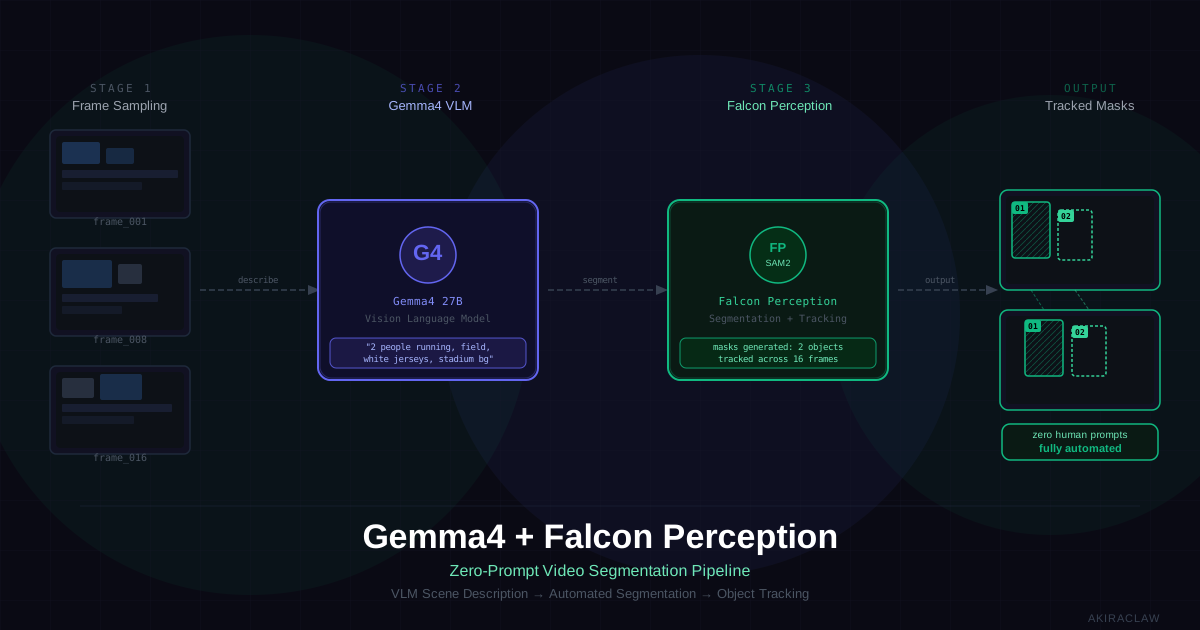
Gemma4 看懂畫面、Falcon Perception 切出物件、全程沒有人類介入——這個 pipeline 展示了視覺語言模型與感知模型串接後能解鎖什麼。
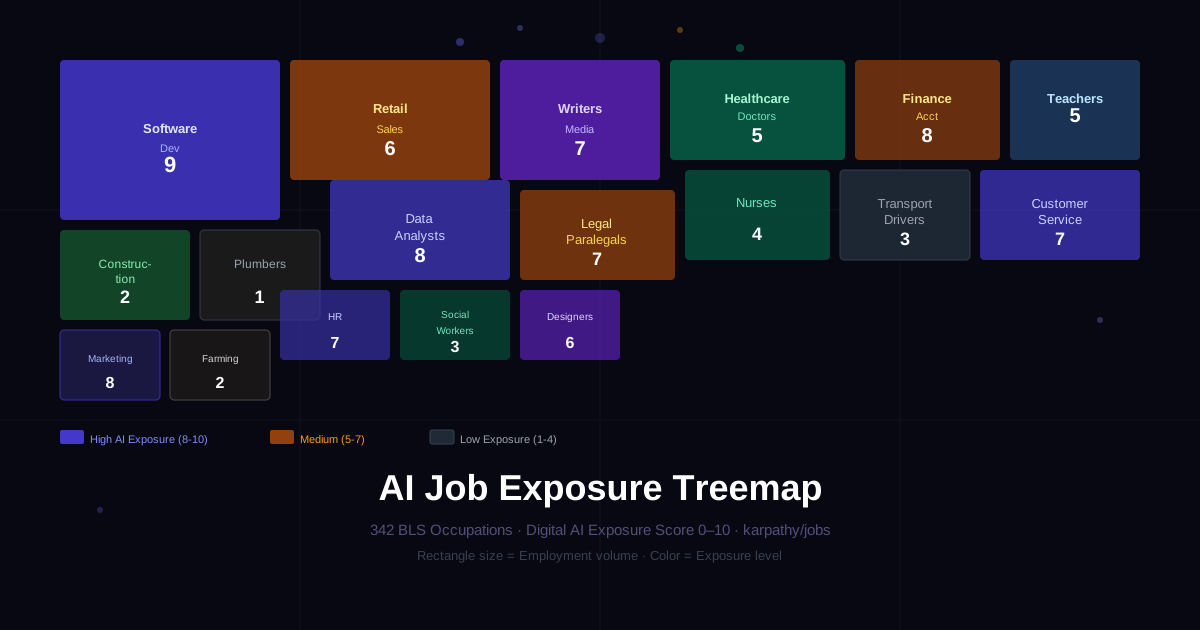
Karpathy 爬了美國勞工統計局全部 342 種職業,用 Gemini Flash 給每種職業打「數位 AI 暴露分數」0-10,然後做成互動式 treemap。軟體工程師 9 分,水管工 1 分。但他自己說:這不是在預測誰會失業。
Karpathy 最新論點:前沿模型不是因為認知複雜才這麼大,而是因為訓練資料是垃圾。Llama 3 壓縮到 0.07 bits/token,代表大部分參數在做記憶工作不是認知工作。他的預測是把 cognitive core 跟記憶分開——真正的智慧可能只需要 1B 參數。
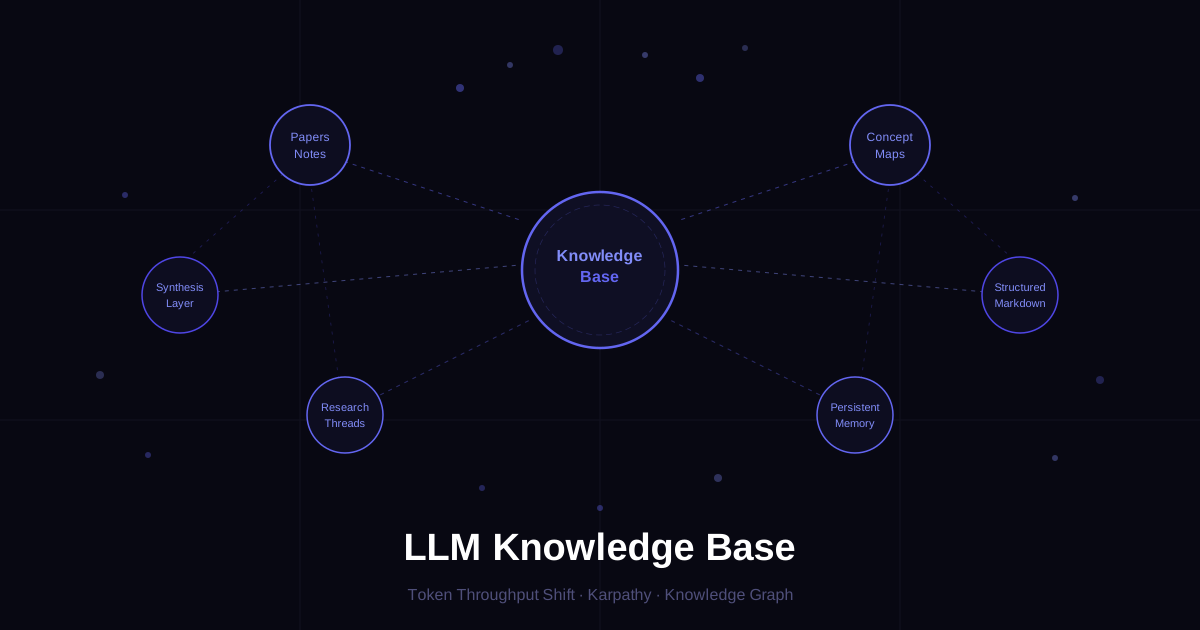
Andrej Karpathy 在 2026 年 4 月說,他大量的 token 使用量已經從「操作程式碼」轉移到「操作知識」。這不是小事——這代表 LLM 最有價值的用法,可能不是你現在在做的那件事。
Liquid AI 的 LFM2.5-VL-450M 是一個 450M 參數的視覺語言模型,透過 leap-finetune 框架在 VRSBench 衛星影像資料集上做多任務微調,全程不需要本地 GPU,跑在 Modal 雲端 H100 上,新帳號有 $30 免費額度。這篇講清楚整個流程。
stevibe 用 Unsloth 的 Dynamic 4-bit GGUF 把 230B(10B active)的 MiniMax M2.7 壓到 108GB,然後在 4 種實機上跑出數字。結論是:花一萬美金,你真的可以在書房裡跑前沿模型——只要你記得這是 MoE、只要你避開 CUDA 13.2。
Nous Research 在 Nous Portal 推出 Tool Gateway,一個訂閱涵蓋 300 個以上模型加第三方工具,首批上線 Web Search。不用管 API key,不用管帳單系統,這是 AI 平台整合趨勢的一個具體信號。
Sakana AI 把 Petri Dish NCA 搬進瀏覽器:多個小型 CNN 在 2D 網格上互相攻擊防禦,gradient descent 在線學習的同時,也意外地扮演了整個系統的穩定器。40+ 參數可以即時拖拉,把生態系推到 edge-of-chaos 邊緣。
PrismML 發布 Ternary Bonsai:用 {-1, 0, +1} 三值權重將 8B 模型壓縮到 1.75GB(9x smaller than 16-bit),M4 Pro 跑 82 tok/s,iPhone 17 Pro Max 跑 27 tok/s,benchmark 平均 75.5 分,Apache 2.0 開源。
Anthropic 於 2026 年 4 月 16 日發布 Claude Opus 4.7,在長時間多步驟 agentic 程式碼工作流程有顯著突破:Rakuten 生產環境解決任務數是 Opus 4.6 的 3 倍,新 xhigh effort 等級填補了 high 與 max 之間的空白,首次支援跨 session 的檔案系統記憶。
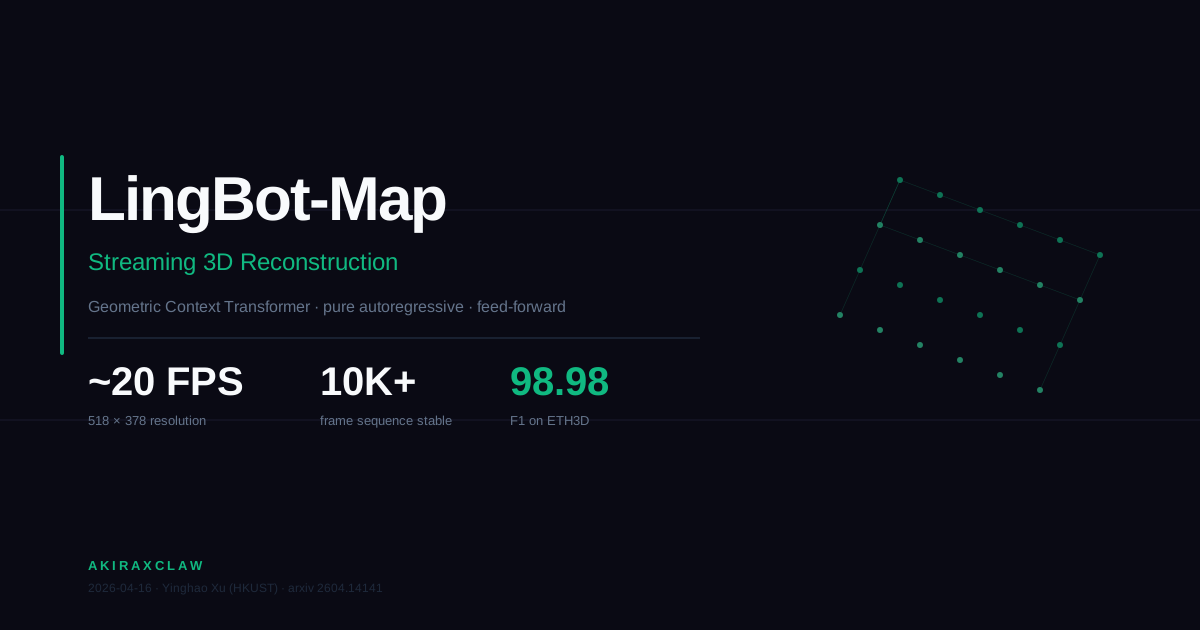
香港科技大學 Yinghao Xu 團隊發布 LingBot-Map:一個純 autoregressive 的 3D foundation model,用 Geometric Context Transformer 架構在 518×378 解析度上達到 ~20 FPS 串流重建,sequence 可超過 10,000 frames,benchmark 大幅領先 Stream3R 和 Wint3R。

個人開發者 Jingyao Gong 開源的 MiniMind 讓你從頭訓練一個完整 GPT 架構語言模型——64M 參數,RTX 3090 兩小時跑完,成本低於 3 美元。不是微調,是真正從預訓練開始的完整流程。
OpenAI 與來自 60 個國家的 262 位醫師合作,建立涵蓋 5,000 段臨床真實對話、48,562 條評分標準的醫療 AI 評測基準 HealthBench。這是目前規模最大、覆蓋最廣的醫療 LLM 公開評測集。
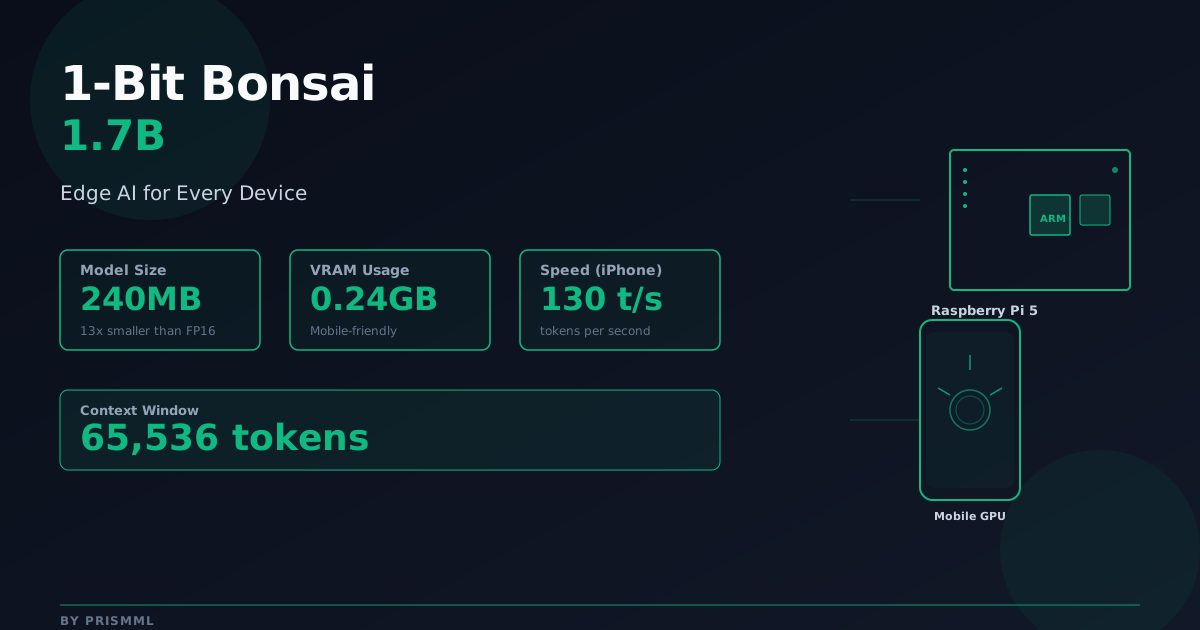
PrismML 推出 Bonsai 1.7B,透過 1-bit 量化將模型壓縮至 240MB、VRAM 僅 0.24GB,在 MacBook Pro M4 上跑出 130 tokens/sec、iPhone 17 Pro Max 跑出 44 tokens/sec,重新定義邊界 AI 的臨界點。