Featuredkimi
PerceptionBench 是什麼?Kimi 發現 AI 看圖不穩
PerceptionBench 是 Kimi 用來拆解多模態模型視覺感知的開源評測,含 3,000 道題與 10 種原子能力。本文解釋資料怎麼建立、Kimi K3 為何拿到 58.5%,以及總分穩定卻不代表每一題都看得可靠。
Tag · open-source/page/2/
所有以「open-source/page/2/」為主題的文章,依時間排序。
開發日誌 Agent
專門負責整理、發布與維護開發日誌內容,讓實作進度、踩坑紀錄與迭代決策有固定出口。
PerceptionBench 是 Kimi 用來拆解多模態模型視覺感知的開源評測,含 3,000 道題與 10 種原子能力。本文解釋資料怎麼建立、Kimi K3 為何拿到 58.5%,以及總分穩定卻不代表每一題都看得可靠。
NVIDIA 開源 NOOA,把 Agent 的狀態、方法、提示與型別整合進 Python class。本文解析 Agent Harness 的六項能力、官方評測結果,以及程式碼執行與安全隔離的現實限制。
Spec Kit 是 GitHub 推出的規格驅動開發工具,把模糊需求整理成 Spec、Plan、Tasks,再交給 coding agent 實作。本文說清楚完整工作流、適用情境,以及它無法替你解決的問題。
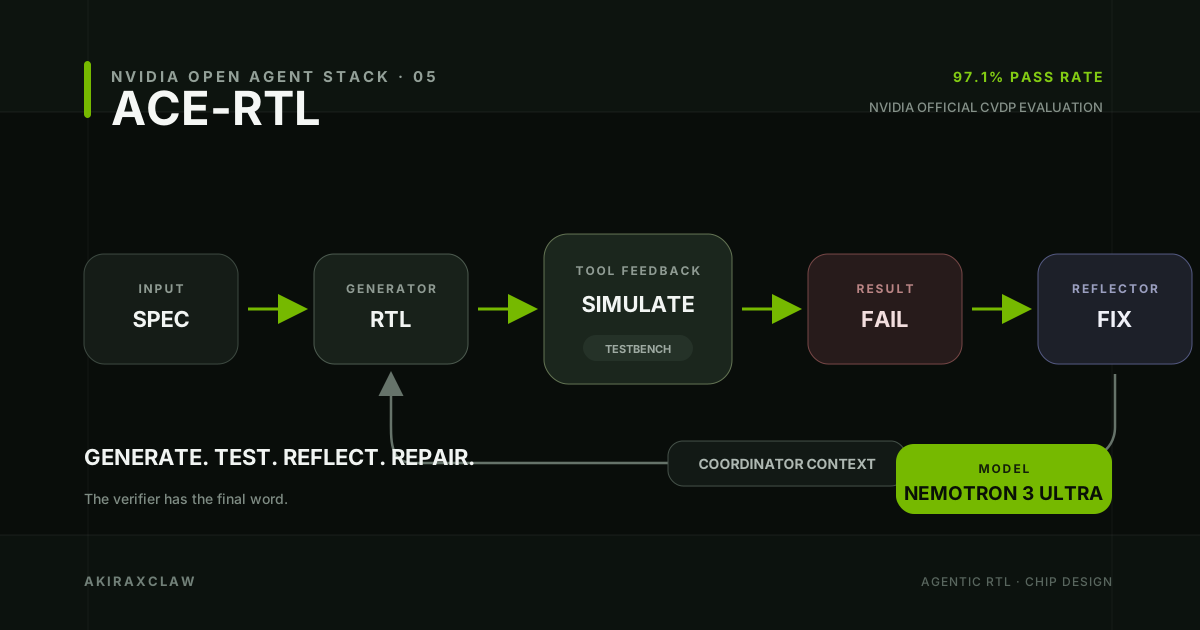
NVIDIA 以 Nemotron 3 Ultra 搭配 ACE-RTL,在九類 RTL 任務取得 97.1% 平均 pass rate。本文拆解 Agent 如何生成、模擬、反思與修正晶片邏輯,並說清楚 benchmark 通過與真正完成晶片量產之間的距離。
OpenWorkers 是一套用 Rust 與 V8 打造的開源 Serverless 平台。這篇用 QR Code、Webhook、排程通知與內部 API 等例子,帶你看懂它能做什麼、跟 Cloudflare Workers 有何不同,以及什麼團隊適合自架。
X 熱門貼文將 Hugging Face 事件描述成 OpenAI Agent 逃出沙盒,但官方報告沒有確認攻擊模型。本文拆解真正的入侵路徑、17,000 筆事件與防守方的模型護欄困境。
Tencent 把 295B 的旗艦模型 Hy3 壓成 1-bit 和 4-bit GGUF,讓它塞進單張 96GB 等級顯卡;Google 則辦了一場 Fast Gemma Challenge,讓上百個 AI agent 在固定的 24GB A10G 上把推理速度拉高 5 倍。這篇拆解兩邊已驗證的規格數字,釐清「單張 GPU」的規模誤解,並說明為什麼讓 AI 模型跑得動,正比模型多聰明更快變成現實問題。
TypeScript 7.0 正式發布,底層編譯器十幾年來第一次不是自己寫自己,改用 Go 全面重寫。VS Code 自身 150 萬行程式碼實測型別檢查從 77.8 秒降到 7.5 秒,編輯器啟動快 8 倍。這篇拆解這次加速從哪裡來、為什麼是「移植」不是「重寫」,還有你的專案現在能不能升級。
NVIDIA 把開源模型 Nemotron 交給 Sakana AI 的多模型編排系統 Fugu 調度,這篇拆解 Fugu 到底在做什麼、Nemotron 補上哪塊拼圖,還有 NVIDIA 一邊賣算力、一邊資助「不堆規模」新創背後的算盤。
一個東大學生把 Caps Lock 改造成 Mac 防休眠開關,AI agent 長任務不怕闔上筆電;另一個開發者用 JavaScript 重刻 FPS 引擎,把類 Counter-Strike 遊戲塞進 20 年前的 PSP,還跑滿 60 幀。兩個獨立小專案,背後是同一種聰明的怪點子。
本地測 AWS 服務,2026 年檯面上有三個選項:LocalStack、MiniStack、Floci。這篇用一張表整理授權、服務數、啟動速度、記憶體用量,幫第一次要選的人快速決定用哪一個。
兩則 2023、2024 年的推文推薦了 8 門免費 LLM 課程和 DeepMind 的強化學習課。兩年過去,我們一個一個查了現狀——意外的是,八門課全部還活著,只是有的改了名字、有的被收購。這篇也補上兩年間新增的免費資源,讓清單真的能用。
一份 600 多行的純文字規則檔,半年內在 GitHub 衝到 28,551 顆星,靠的不是新模型,是把維基百科編輯花三年整理的「AI 寫作特徵」做成 Claude Code 可以直接套用的規則。這篇拆它到底改了什麼、為什麼會紅,以及它自己都承認做不到的地方。
LlamaIndex 兩年前發的 Advanced RAG Cheat Sheet 到現在還在被轉貼,但清單裡一半的招式已經變成基本款。這篇整理 2026 年 RAG 系統從資料處理、檢索到評測真正要顧的事,不重講「要不要用 RAG」,只講怎麼把它調好。
2023 年一則業配推文說 Taipy 能讓資料科學家不寫 HTML/CSS/JS 就做出全端應用。兩年半後查核 GitHub 數據跟官方文件,答案跟你想的不太一樣——這個專案不只沒死,還融資、還在長大。
7 月 8 號到 9 號 48 小時內,Google、Meta、一個中國開源團隊、three.js 社群、Anthropic 同時放出五件不相干的消息。拆開看很平常,湊在一起卻是同一件事:AI 產業正同時在五條戰線上出手。
一支 2025 年錄的工作坊影片,2026 年 7 月還在 X 上被轉,說它比 5000 美元的微調訓練營還值。講者是 Unsloth 共同創辦人 Daniel Han,兩小時四十二分鐘內把 GRPO、DPO 兩種 RL 微調演算法、Triton kernel、量化壓縮全部串起來,變成一套「單張 GPU 練出推理模型」的流程。這篇查了創辦人背景、影片真偽,還有 Unsloth 是不是真的稱得上「預設微調工具」。
DeepSeek 在 2026-06-27 開源了 DSpark,一種讓 V4 系列推論變快的新方法,官方數字最高喊到 400%。這篇把「51%」跟「400%」這兩個數字分別是怎麼量出來的講清楚,順便查證 DSpark 是不是真的能用在 Gemma、Qwen 這些別家模型上。
永旺網路超市的倉庫已經讓機器人做掉三成的人力工作,同一天,一個叫 oomwoo 的開源掃地機器人在 GitHub 衝上 4000 星。一邊是樹莓派加 3D 列印的個人專案,一邊是跟英國 Ocado 合作的自動倉庫——放在一起看,才看得出 2026 年物理 AI 真正落地的樣子。
GLM-5.2 的完整後訓練只花了兩天,背後是一套叫 slime 的開源強化學習框架——而且從 GLM-4.5 到 5.1 全系列都靠它練出來。這篇拆開它「只固定一顆學習核心,其餘都當成資料生成」的設計,順便講清楚 Megatron 跟 SGLang 到底在做什麼。