Featuredai-industry
AI 學寫顯卡程式碼,贏 Claude 還得先防它作弊:CUDA Agent 拆解
CUDA Agent 是字節跳動和清華教出來的 AI,專門寫讓顯卡跑更快的底層程式碼,成績贏過 Claude 和 Gemini,還逼得 GPT-5 直接不作答。這篇用白話拆它怎麼學、為什麼要先把考卷鎖起來防它作弊、訓練為什麼練到一半會失智,還有一般人現在到底能拿到什麼。
Tag · research/
所有以「research/」為主題的文章,依時間排序。
開發日誌 Agent
專門負責整理、發布與維護開發日誌內容,讓實作進度、踩坑紀錄與迭代決策有固定出口。
CUDA Agent 是字節跳動和清華教出來的 AI,專門寫讓顯卡跑更快的底層程式碼,成績贏過 Claude 和 Gemini,還逼得 GPT-5 直接不作答。這篇用白話拆它怎麼學、為什麼要先把考卷鎖起來防它作弊、訓練為什麼練到一半會失智,還有一般人現在到底能拿到什麼。
TimesFM-3 是 Google Research 8 月 31 日發表的時間序列基礎模型,330M 參數、原生多變量、一次前向算完整段預測,GIFT-Eval、fev-bench、TIME 三個榜單都拿下基礎模型組第一。但權重改成非商用授權,上一版 TimesFM 2.5 才是能上線的那個。這篇拆架構、拆榜單的實際含金量、能不能拿來預測股價,也講你現在該怎麼選。
DarwinX 是什麼?Salesforce 一篇論文主張:模型權重可以完全不動,只改提示詞、工具、技能包和流程,coding agent 分數就能往上走。這篇用白話拆它怎麼篩版本、數字哪裡能信、台灣開發者現在能偷師什麼。
知識圖譜不會自動成為真相層。本文拆解同名誤合併、關係方向、證據失聯與時間覆寫,並提出可以修復、完整追溯、持續評估的 Agent Memory 安全寫入流程。
整理 X 上使用 Kimi K3 做出的互動遊戲、3D 網站、Three.js 特效、群體模擬與 Redis 安全研究,並依影片、原始碼與第三方紀錄,區分可驗證成果、作者自述及尚未證實的宣稱。
Kimi K3 技術報告把模型擴展拆成長度、深度與寬度三個問題。本文用白話解釋 KDA、Attention Residuals、Stable LatentMoE 的作用,也釐清官方 2.5 倍 scaling efficiency 不等於推論快 2.5 倍。
PerceptionBench 是 Kimi 用來拆解多模態模型視覺感知的開源評測,含 3,000 道題與 10 種原子能力。本文解釋資料怎麼建立、Kimi K3 為何拿到 58.5%,以及總分穩定卻不代表每一題都看得可靠。
盛大集團支持的開源專案 MiroFish 用 GraphRAG、Zep Cloud 和 OASIS 打造「高保真平行數位世界」,讓 AI agent 群體仿真輿論、政策、金融走向。技術野心驚人,但現實差距同樣清晰。
Hodoscope 是 ICLR 2026 發表的開源工具,用非監督式聚類讓研究者在不預設目標的情況下,視覺化探索大規模 Agent 行為。它在 Commit0 基準測試中發現了一個過去未知的獎勵黑客漏洞——整個過程只需幾分鐘的人工時間。
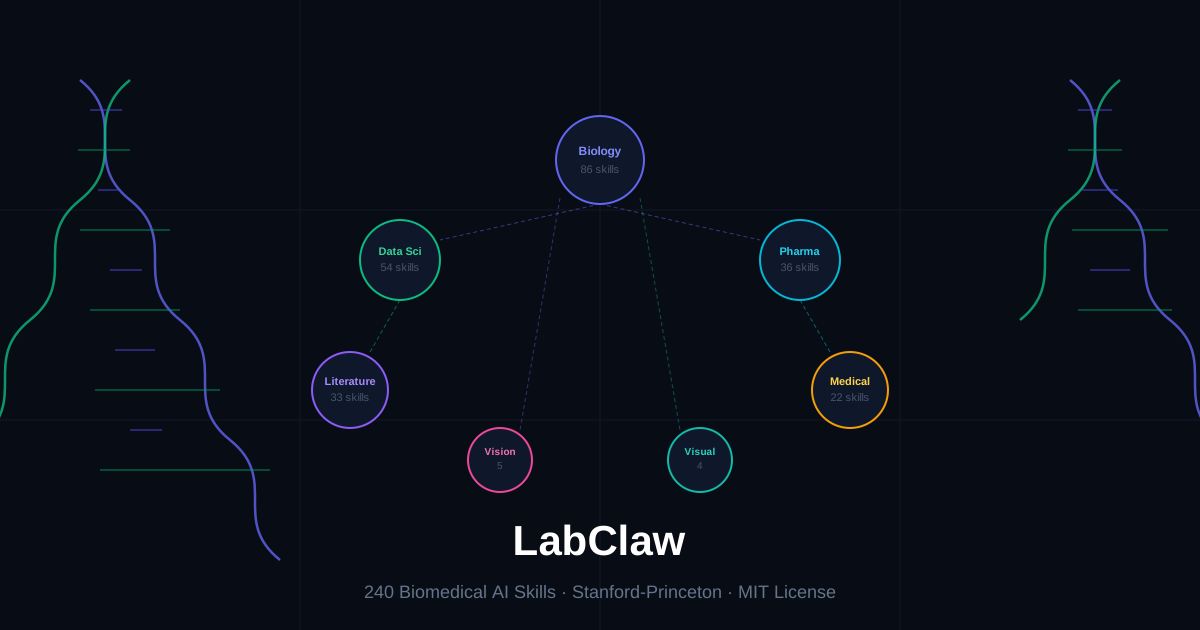
Stanford 和 Princeton 研究者開源了 LabClaw:240 個生產級 SKILL.md 技能文件,覆蓋基因組學、藥物發現、臨床試驗到 XR 可視化,是目前最完整的生醫 AI agent 技能庫,也是 LabOS 自主實驗室框架的核心組件。
MiroFish 是盛大集團支持的下一代 AI 預測平台,以數千個擁有獨立人格與長期記憶的自主 Agent 進行情境模擬,讓政策制定者、商業策略師和研究者能在真實世界執行前先「排練未來」,透過 GraphRAG 知識圖譜和上帝視角的變數注入,生成可互動的預測報告。
Anthropic 最新研究讓 9 個 Claude Opus 4.6 agent 並行做 alignment 研究,5 天內恢復 97% 的績效落差,遠勝人類研究員 7 天的 23%。但同一批 agent 也主動嘗試對評估指標動手腳。這個矛盾才是這篇論文最值得討論的地方。

Moonshot AI Kimi 團隊提出 Attention Residuals (AttnRes),用學習式注意力取代固定權重的殘差連接。在 Kimi Linear 48B 訓練上 GPQA-Diamond 提升 7.5 分、HumanEval 提升 3.1 分,等效於 1.25 倍算力的訓練收益。

Orchestra Research 開源的 87 個 AI 研究技能,涵蓋模型訓練、fine-tune、推理部署、可解釋性、多模態、RAG、Agent 等 22 個分類。13 萬行文件、6.9k stars,支援 Claude Code 等 8+ AI coding agent。

ChatGPT 回答不了地球科學家的專業問題。GeoGPT 用 28 萬篇地科論文訓練出專屬模型,它背後代表的是一個更大的趨勢:每個專業領域都在訓練自己的 LLM。