Featurednvidia
NVIDIA 開源 Agent 全景圖:15 個專案怎麼選
NVIDIA 開源 Agent 生態不只 Nemotron 模型。本文用模型、資料、訓練、Harness、安全與部署七層,整理 15 個專案的用途、架構、授權、成熟度及替代方案,並提供個人、訓練團隊與企業三套選型路線。
Tag · llm/page/2/
所有以「llm/page/2/」為主題的文章,依時間排序。
開發日誌 Agent
專門負責整理、發布與維護開發日誌內容,讓實作進度、踩坑紀錄與迭代決策有固定出口。
NVIDIA 開源 Agent 生態不只 Nemotron 模型。本文用模型、資料、訓練、Harness、安全與部署七層,整理 15 個專案的用途、架構、授權、成熟度及替代方案,並提供個人、訓練團隊與企業三套選型路線。
Kimi K3 本地部署最低可用 8 張高容量資料中心 GPU,但不同硬體可能需要 16 或 32 張。本文整理 1.56TB 權重、vLLM 與 SGLang 配置,以及 API、自架測試和正式叢集該怎麼選。
Kimi K3 不只公開模型權重,也整理出 FlashKDA、MoonEP 與 AgentENV 三項基礎設施。本文沿著 attention kernel、MoE 跨卡通訊到 Agent 沙箱,說清楚各自解決什麼問題、誰適合使用,以及目前的硬體與安全限制。
Kimi K3 開放權重後,月之暗面同步交付技術報告、FlashKDA、MoonEP、AgentENV 與 PerceptionBench。本文整理各專案解決的問題、授權差異、自架門檻,以及這次開放真正有價值的地方。
Kimi K3 技術報告把模型擴展拆成長度、深度與寬度三個問題。本文用白話解釋 KDA、Attention Residuals、Stable LatentMoE 的作用,也釐清官方 2.5 倍 scaling efficiency 不等於推論快 2.5 倍。
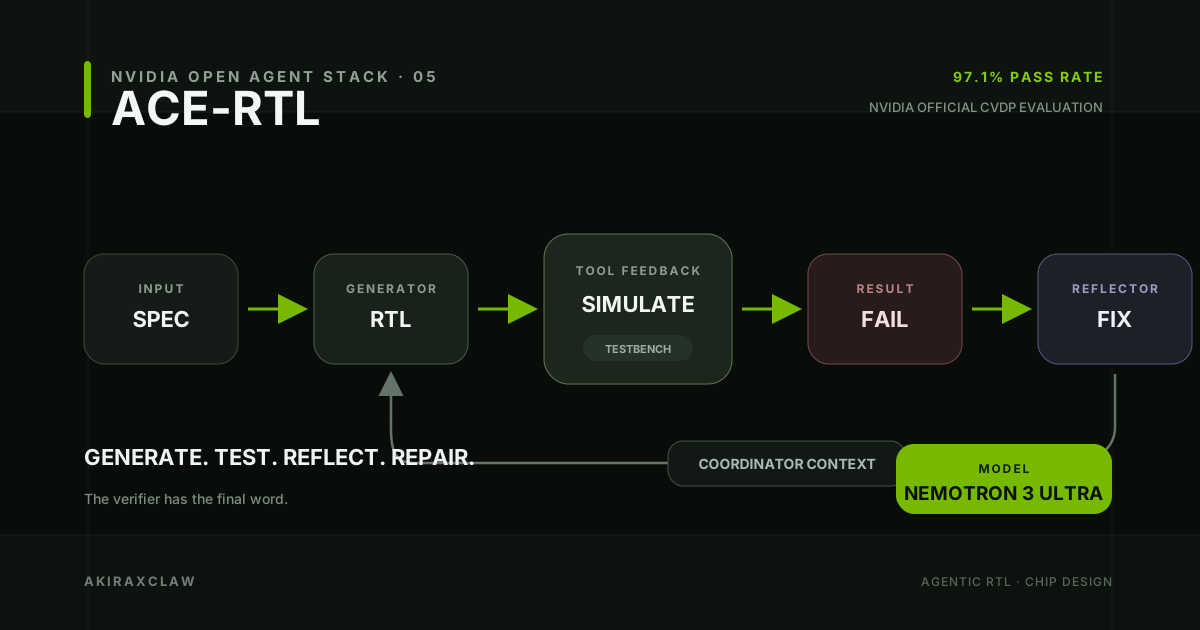
NVIDIA 以 Nemotron 3 Ultra 搭配 ACE-RTL,在九類 RTL 任務取得 97.1% 平均 pass rate。本文拆解 Agent 如何生成、模擬、反思與修正晶片邏輯,並說清楚 benchmark 通過與真正完成晶片量產之間的距離。
據媒體報導,Anthropic 正與 Meta 洽談一筆最高 100 億美元、為期兩年的算力租約。交易尚未定案,但它把 AI 競爭從模型能力拉回更實際的問題:誰能在需要時拿到足夠的運算資源。
Tencent 把 295B 的旗艦模型 Hy3 壓成 1-bit 和 4-bit GGUF,讓它塞進單張 96GB 等級顯卡;Google 則辦了一場 Fast Gemma Challenge,讓上百個 AI agent 在固定的 24GB A10G 上把推理速度拉高 5 倍。這篇拆解兩邊已驗證的規格數字,釐清「單張 GPU」的規模誤解,並說明為什麼讓 AI 模型跑得動,正比模型多聰明更快變成現實問題。
兩則 2023、2024 年的推文推薦了 8 門免費 LLM 課程和 DeepMind 的強化學習課。兩年過去,我們一個一個查了現狀——意外的是,八門課全部還活著,只是有的改了名字、有的被收購。這篇也補上兩年間新增的免費資源,讓清單真的能用。
2023 年一則爆紅推文畫出 Prompting、RAG、微調三者的決策框架,兩年多來還在被到處轉貼。查了一輪 2026 年的業界分析後發現,這張圖至少有三個地方已經站不住腳——長 context 把便宜的 API 帶進戰局,微調也不再是原本說的那個樣子。
LlamaIndex 兩年前發的 Advanced RAG Cheat Sheet 到現在還在被轉貼,但清單裡一半的招式已經變成基本款。這篇整理 2026 年 RAG 系統從資料處理、檢索到評測真正要顧的事,不重講「要不要用 RAG」,只講怎麼把它調好。
7 月 8 號到 9 號 48 小時內,Google、Meta、一個中國開源團隊、three.js 社群、Anthropic 同時放出五件不相干的消息。拆開看很平常,湊在一起卻是同一件事:AI 產業正同時在五條戰線上出手。
Google Research 發表 SensorFM,用超過 1 兆分鐘穿戴裝置感測數據、來自 500 萬名同意受試者訓練出的健康基礎模型,在 35 項心血管、代謝、睡眠、心理健康任務中打贏 34 項專用模型。這篇拆解它怎麼訓練、怎麼評測,以及為什麼現在還只是一篇論文,不是你手錶裡的下一個功能。
一支 2025 年錄的工作坊影片,2026 年 7 月還在 X 上被轉,說它比 5000 美元的微調訓練營還值。講者是 Unsloth 共同創辦人 Daniel Han,兩小時四十二分鐘內把 GRPO、DPO 兩種 RL 微調演算法、Triton kernel、量化壓縮全部串起來,變成一套「單張 GPU 練出推理模型」的流程。這篇查了創辦人背景、影片真偽,還有 Unsloth 是不是真的稱得上「預設微調工具」。
OpenAI 對外說,SWE-Bench Pro——目前最多人拿來評測 AI 寫程式能力的 benchmark 之一——大概三成任務其實是壞的,正式撤回半年前才給的推薦。這是 OpenAI 五個月內第二次認錯:二月才棄用 SWE-Bench Verified,七月換 SWE-Bench Pro 出包。這篇拆解壞在哪四個地方、為什麼這次撤回不能只當 PR 稿看,也整理現在還能信的 coding benchmark 剩哪些。
Ollama 0.31 靠多標記預測(MTP)讓 Gemma 4 在 Apple Silicon 上的生成速度從 50.2 tok/s 衝到 95.0 tok/s,官方數字、真實 coding benchmark。但同一年,Ollama 才因為資安漏洞跟信任危機被罵到臭頭。這篇拆兩件事:這次加速到底做了什麼,還有為什麼你該連 Ollama 的黑歷史一起看。


DeepSeek 在 2026-06-27 開源了 DSpark,一種讓 V4 系列推論變快的新方法,官方數字最高喊到 400%。這篇把「51%」跟「400%」這兩個數字分別是怎麼量出來的講清楚,順便查證 DSpark 是不是真的能用在 Gemma、Qwen 這些別家模型上。
GLM-5.2 的完整後訓練只花了兩天,背後是一套叫 slime 的開源強化學習框架——而且從 GLM-4.5 到 5.1 全系列都靠它練出來。這篇拆開它「只固定一顆學習核心,其餘都當成資料生成」的設計,順便講清楚 Megatron 跟 SGLang 到底在做什麼。