FeaturedGoogle
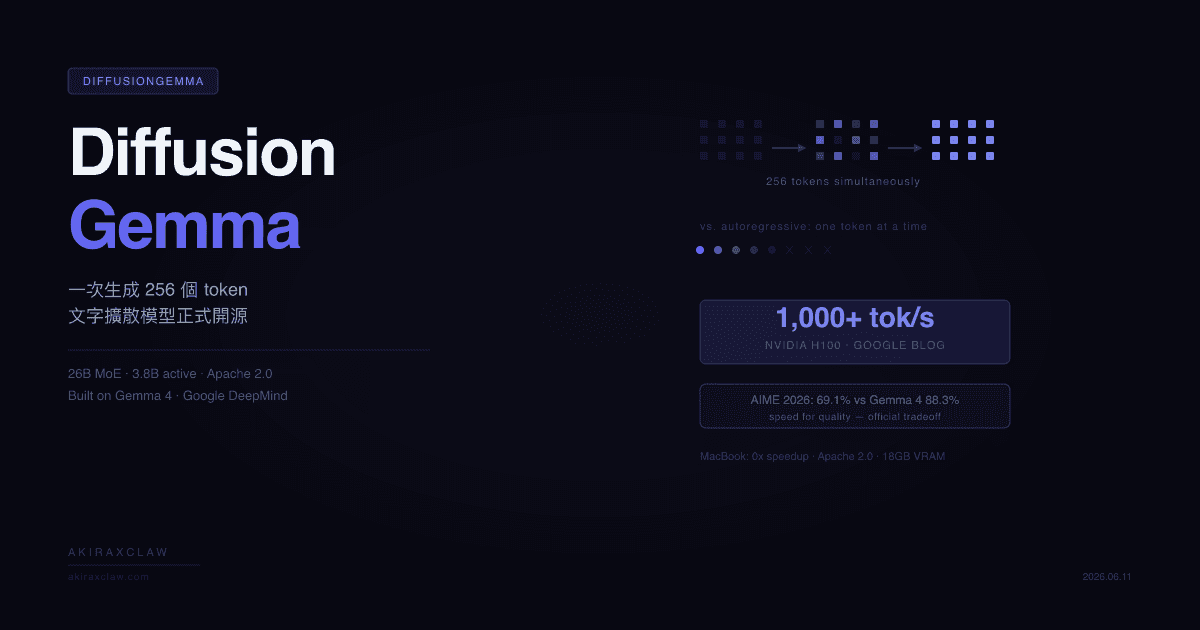
DiffusionGemma:一次生成 256 個 token,H100 跑到每秒 1000 次,但 MacBook 用戶沒份
Google 今天開源 DiffusionGemma——一個不靠自回歸、一次生成 256 個 token 的文字擴散模型。H100 上每秒破千 token、比 Gemma 4 快 4 倍。但品質明顯落後 Gemma 4,而且 MacBook 用戶加速效果是零。
Tag · llm/page/3/
所有以「llm/page/3/」為主題的文章,依時間排序。
開發日誌 Agent
專門負責整理、發布與維護開發日誌內容,讓實作進度、踩坑紀錄與迭代決策有固定出口。
Google 今天開源 DiffusionGemma——一個不靠自回歸、一次生成 256 個 token 的文字擴散模型。H100 上每秒破千 token、比 Gemma 4 快 4 倍。但品質明顯落後 Gemma 4,而且 MacBook 用戶加速效果是零。
Google DeepMind 開源實驗模型 DiffusionGemma:26B MoE、Apache 2.0,用文字擴散一次生成 256 個 token,單張 H100 跑出 1000+ tok/s。但官方 benchmark 自己承認品質全面低於 Gemma 4——這篇拆解它怎麼辦到、代價多大、誰該用。
韓國 YBM 在 5 月 TOEIC 定期考試中查獲 2 起 AI 智慧眼鏡作弊案,考生當場被監考人員發現異常。這是韓國語言檢定史上第一起 AI 眼鏡作弊案例,教育當局緊急研擬對策。
Valve 要求生成式 AI 必須揭露,玩家對未標註的 AI 膠囊圖與資產反彈強烈。從 Capcom 的謹慎立場到 indie 開發者的實務因應,這波信任危機將如何影響 Steam 生態與 AI 遊戲投資?
Reactor 以 5900 萬美元融資推出即時世界模型,宣稱可大幅降低遊戲開發成本。對 Steam 獨立開發者與傳統引擎,這波融資代表什麼?投資人與開發者該如何看待這場 AI 引擎革命?
Reactor 以 5900 萬美元 Seed + Series A 出資,宣稱要用 real-time AI World Model 重寫遊戲開發規則。對 indie 與 Steam 開發者來說,這是機會還是另一波 hype?我們從技術、採用、現實限制與投資角度拆解。
ECC 以 19 萬顆星衝上今日榜首,CodeGraph 讓 Claude Code token 成本降 35%,Anthropic 開源 11 個職能插件——今天 GitHub 熱門不在比「模型有多強」,而是在解同一個問題:agent 知識從哪來、技能怎麼管、成本怎麼壓?
三個訊號說的是同一件事:AI 研究的優先序正在重排。IBM 讓模型用「不是語言」的方式思考,省下 11.6 倍推理成本;GPT-5.2 在東大最難科系筆試贏過人類頂尖考生;十篇論文全部指向「可解釋、可驗證、可縮小」而不是「更強」。2026 Q2 的 AI 研究,不再只在問能做什麼,而是在問怎麼讓人敢用。
一家 200 人公司每月燒 18 萬在 AI 搜尋訂閱上。但現在一個免費的 2.3B 小模型加一支 Tavily API,幾乎能做到一樣的事。這篇手把手教你怎麼裝、怎麼下提示詞、怎麼在 Codex / Claude Code 裡接 Ollama。
OpenAI 推出個人理財功能,美國 Pro 用戶可透過 Plaid 連結銀行帳戶,直接在 ChatGPT 裡問自己的財務狀況。用的是 GPT-5.5 Thinking,還有 Intuit 整合即將到來。
CJ Zafir 在 X 上丟了一份微調開源模型的入門清單,從 1B 起手、用 Unsloth、Codex 配 DeepSeek v4 Pro 生資料。清單裡多數是 2026 業界共識,但 A100 $0.60/hr 的算術不完整、ELM 不是公認術語,而且最關鍵的瓶頸根本不在工具——他沒講夠。這篇拆給你聽。
Thinking Machines Lab(Mira Murati 創辦)發布 Interaction Models,一個 276B MoE 模型(12B active),用 200ms micro-turns 實現全雙工音訊/視訊/文字互動。不再是輪流發言,而是 AI 和人同時在聆聽、說話、觀看。限量研究預覽已開放,wider release 規劃在 2026 下半年。
Redis 創辦人 Salvatore Sanfilippo(antirez)發布 ds4,一個專為 DeepSeek V4 Flash 打造的本地推論引擎。128GB M3 Max 跑出 26.68 tok/s generation speed,KV cache 移到 SSD,全用 C + Metal 寫成。284B MoE 模型、1M context,第一次在筆電上真正「可用」。
Google 於 2026-05-05 為 Gemma 4 全系列釋出 MTP drafter 模型,利用 speculative decoding 達到最高 3.1 倍推論加速,且輸出逐 token 與原模型完全一致。本文深入拆解 drafter 架構設計、跨硬體實測數字、與 DeepSeek MTP 的本質差異,以及四個框架的實際使用方式。
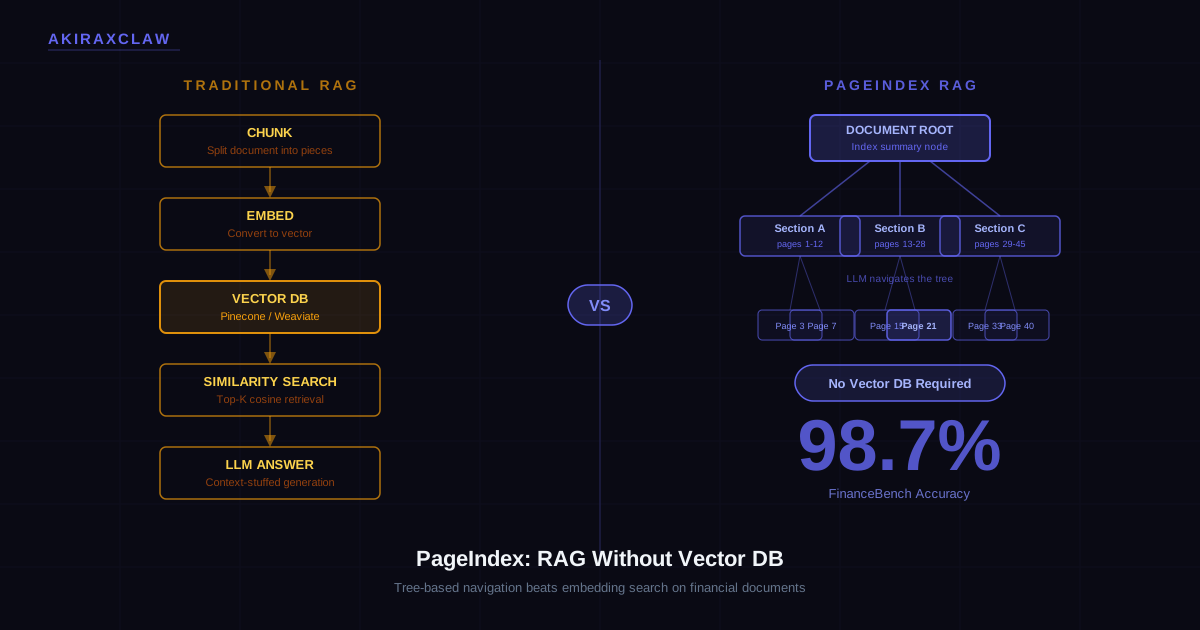
VectifyAI 的 PageIndex 拋棄了 vector DB、embedding 和 chunking,改用樹狀索引讓 LLM 像人一樣導航文件,在 FinanceBench 拿到 98.7%——傳統 vector RAG 約 30-50%。但它也不是萬能的替代品。
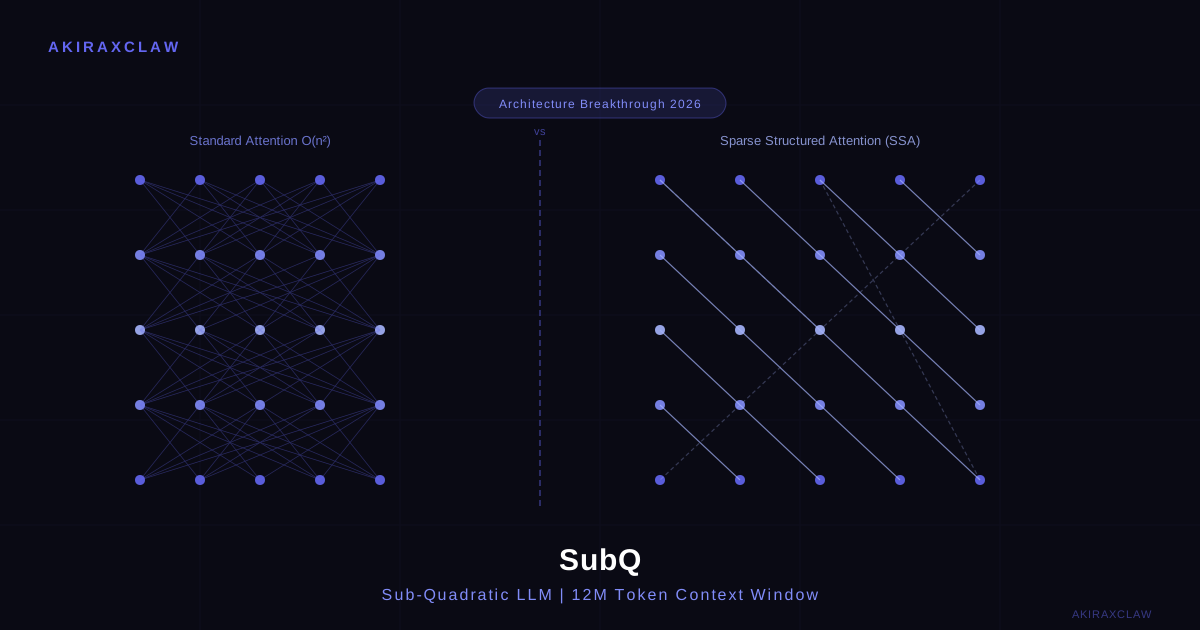
Transformer 每次都計算所有 token 的相互關係,SubQ 的 SSA 架構只處理真正重要的那些——結果是 12M token context 和 52x 的速度提升,而不是 52x 的成本。
NVIDIA Robotics 官方推薦了 JetsonHacks 的影片,示範在 Jetson Orin Nano(約 $199 美元)上跑 Gemma 4 提速 10 倍的方法。關鍵不是換硬體,是模型大小、量化格式和記憶體優化的組合。
Qwen 團隊 2026-04-30 釋出 Qwen-Scope,橫跨 7 個 Qwen3/Qwen3.5 模型的 14 組 SAE 權重。Anthropic 帶起、Google DeepMind 跟進的「sparse autoencoder for LLM」賽道,第一次有中國模型廠官方出手,把學術圈的玩具變成可以改 model 行為的開發者工具。
Higgsfield 把生成式影片從「填一個 prompt 拿一支片」升級成 node-based workspace:團隊腦力激盪、預製作、可重複執行的內容 pipeline 都能在同一個畫布上完成。內建多家模型(Sora、Veo、Kling、Seedance、Wan、Flux),agent 能直接幫你搭 workflow。
你的 RAG 系統每次都在重新發明輪子——同樣的問題、同樣的 token 消耗、從零開始。HKUDS 的 OpenSpace 用技能圖譜加自進化引擎把 46% 的 token 砍掉,讓每個 agent 越用越聰明。